LLM Agent 的不确定性量化:从单轮 QA 到交互式轨迹的范式跃迁
Uncertainty Quantification in LLM Agents: Foundations, Emerging Challenges, and Opportunities
威斯康星大学 Sharon Li 团队联合 UC Berkeley Dawn Song 等多位学者,首次系统性地提出了 LLM Agent 不确定性量化(Agent UQ)的通用框架。论文用动态贝叶斯网络建模 Agent 轨迹,将总不确定性分解为动作不确定性与观测不确定性的逐轮累加,并指出四项核心技术挑战:估计器选择、异构实体、不确定性动态、细粒度基准匮乏。在 τ²-bench 上的实验表明,现有 UQ 方法在 Agent 场景中表现普遍不佳,呼唤全新的交互式不确定性建模范式。
论文概览
当 LLM Agent 开始替我们预订航班、修改数据库、执行不可逆操作时,一个老问题变得异常紧迫:Agent 自己知道它什么时候可能出错吗? 这篇论文给出的答案是——目前不知道,而且我们连"如何让它知道"的理论框架都还没有建好。
论文来自威斯康星大学麦迪逊分校的 Sharon Li 团队,联合 CMU、UC Berkeley(Dawn Song)、宾大、南加大等多家机构,发表于 arXiv(2602.05073)。核心论点很直接:现有的不确定性量化(UQ)研究几乎全部聚焦于单轮问答场景——给一个问题,生成一个答案,估计这个答案对不对的概率。但 Agent 的现实是多轮、交互式、长轨迹的,Agent 会主动搜集信息、与环境对话、在中间步骤做出不可逆决策。在这种设定下,单轮 UQ 的理论假设(静态系统、无新信息获取)全部失效。
论文贡献分三块:(1)提出 Agent UQ 的首个通用数学公式;(2)在 τ²-bench 上实证识别四项技术挑战;(3)展望医疗、编程、机器人三个领域的实践意义和开放问题。
原文链接:arXiv:2602.05073
项目页面:https://agentuq.github.io/
数据集:HuggingFace: tau2-uq-artifacts
核心创新
创新一:从静态 QA 到交互式轨迹的 UQ 统一框架
论文最核心的贡献是用动态贝叶斯网络将 Agent 的交互过程形式化。定义 Agent 轨迹为 ,其中 是环境状态、 是第 轮观测、 是第 轮动作。每一轮的生成过程为:
其中 是 LLM 策略, 是工具集, 是确定性环境更新函数。利用信息论中不确定性的链式法则,总不确定性可以分解为:
这个公式优雅之处在于:初始不确定性 + 每一轮的动作不确定性 + 观测不确定性。更重要的是,现有单轮 UQ(只考虑 )和多步推理 UQ()都是这个框架的特例——它们要么忽略了交互反馈,要么忽略了观测不确定性。
创新二:四项 Agent 特有的技术挑战
论文在 τ²-bench 上用 GPT-4.1 和 Kimi-K2.5 做了实验,揭示了四个关键瓶颈:
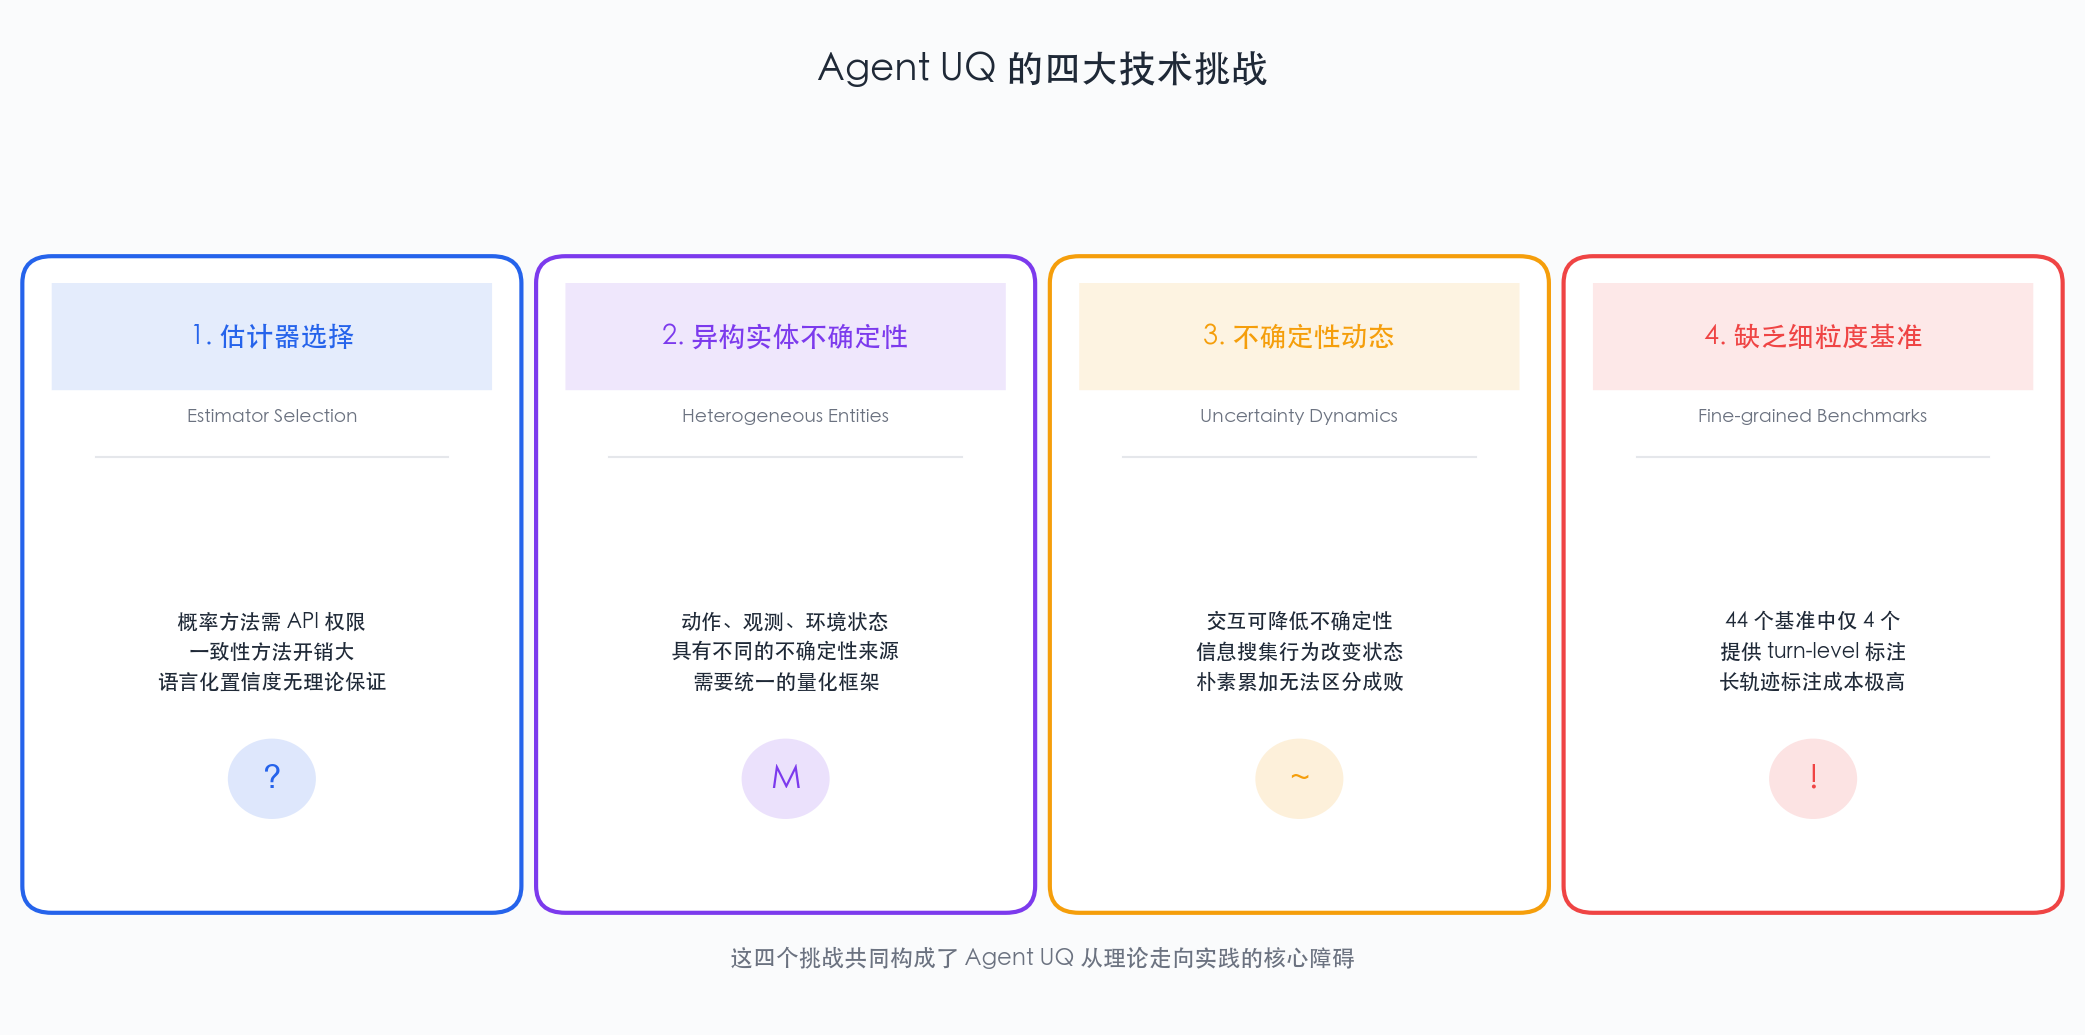
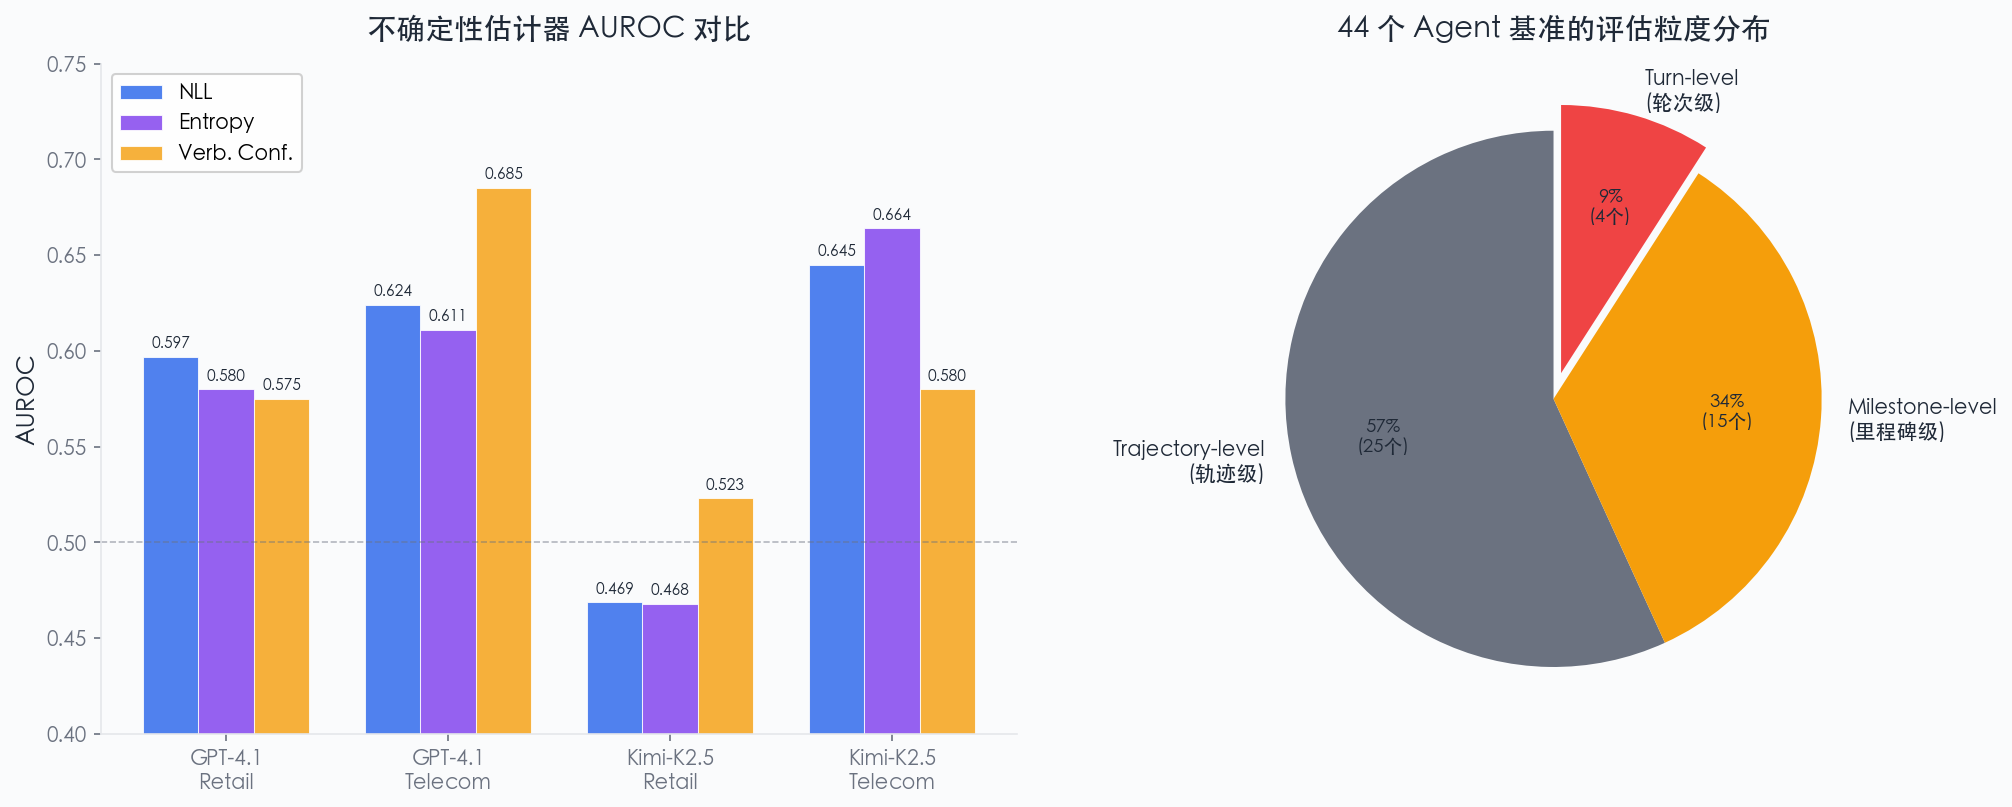
挑战 1:估计器选择。 三类 UQ 方法各有硬伤——概率方法需要 logprob 访问权(闭源模型不提供);一致性方法需要多次采样(Agent 轨迹长,开销指数级增长);语言化置信度最实用但无理论保证。论文实验显示,语言化置信度在 GPT-4.1 Telecom 场景 AUROC 达 0.685,反而优于 NLL(0.624)和 Entropy(0.611),但在 Kimi-K2.5 上表现最差。
挑战 2:异构实体。 Agent 轨迹中动作(调用工具)、观测(环境返回)、环境状态(数据库变更)是性质完全不同的实体,如何统一量化它们的不确定性?现有方法一刀切地用同一种度量,忽略了异构性。
挑战 3:不确定性动态。 这是最深刻的发现——在交互式系统中,不确定性可被主动降低。Agent 通过提问、搜索、工具调用来消除歧义,这导致成功轨迹的不确定性应该随交互递减。但实验显示,朴素的累加方法(Eq. 6)无法区分成功与失败轨迹:
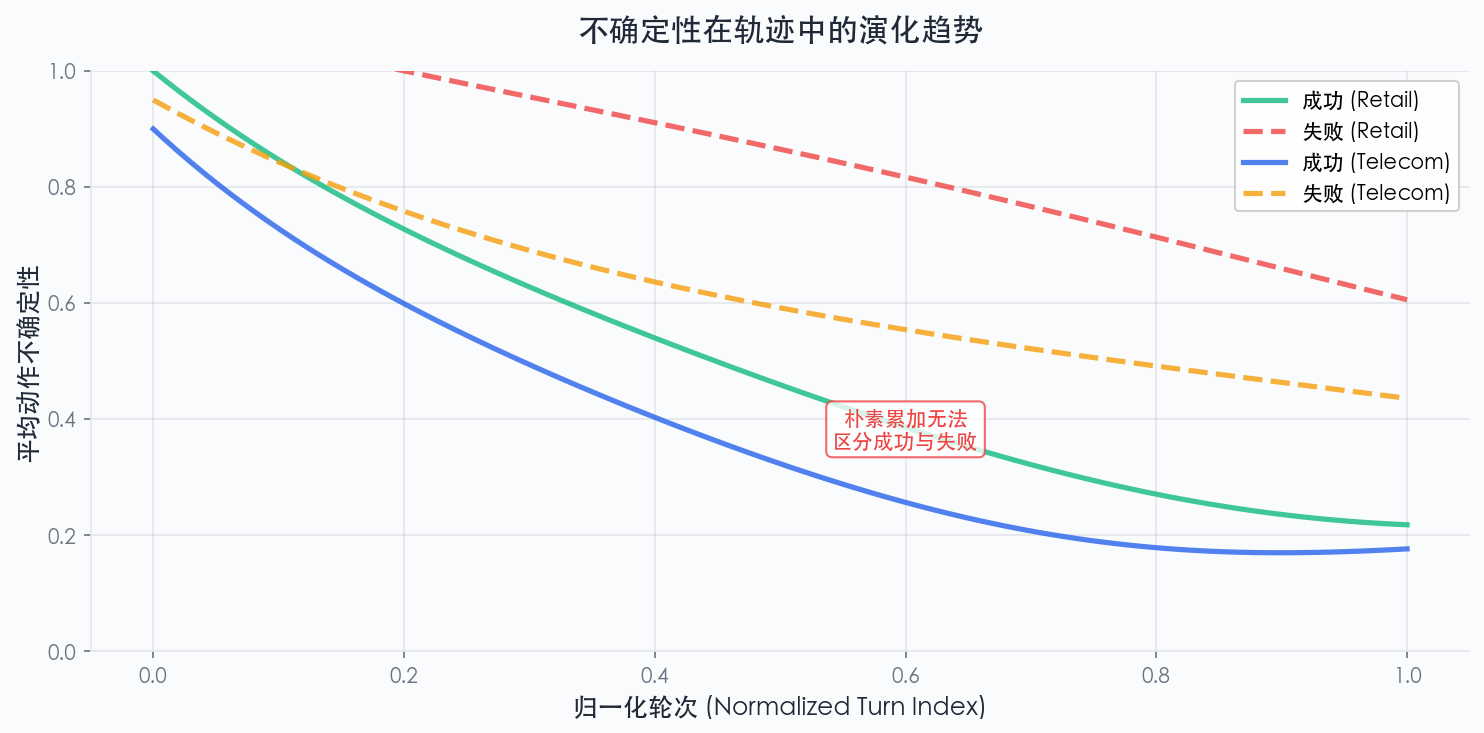
在 Telecom 场景中,失败轨迹的不确定性下降速度甚至快于成功轨迹——因为失败 Agent 可能在早期就"锁死"在错误路径上,后续动作高度确定但方向错误。这说明不确定性低 ≠ 正确,需要引入动作条件的不确定性建模。
挑战 4:细粒度基准匮乏。 论文调研了 44 个 Agent 基准,只有 4 个提供 turn-level 标注。长轨迹(动辄上百步)的逐步标注成本极高,这直接限制了 Agent UQ 方法的开发和评估。
实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 基准 | τ²-bench(Retail、 Telecom 两个场景) |
| 模型 | GPT-4.1、 Kimi-K2.5 |
| UQ 方法 | NLL、 Entropy、 Verbalized Confidence |
| 指标 | AUROC、 Spearman ρ、 Kendall τ |
| 评估目标 | 预测任务成功/失败 |
主要结果
关键发现:
- 没有通用赢家:NLL 在 Kimi-K2.5 Telecom 上最优(AUROC 0.645),但语言化置信度在 GPT-4.1 Telecom 上最优(AUROC 0.685)。不同模型/场景的最佳估计器不同。
- 接近随机:Kimi-K2.5 Retail 上所有方法 AUROC < 0.53,几乎等于随机猜测。说明当模型能力与任务难度不匹配时,UQ 信号几乎完全失效。
- 相关性弱:Spearman ρ 普遍低于 0.33,Kendall τ 普遍低于 0.29。不确定性估计与任务结果之间的关联很弱。
- 基准粒度严重不足:44 个基准中仅 4 个(9%)提供 turn-level 标注,而 trajectory-level 占了 57%。
启示与思考
这篇论文让我觉得最值得深思的地方,不在于它给出了多少解决方案,而在于它清晰地勾勒出了问题的边界和难度。
第一层启示是关于 UQ 范式的根本转变。 传统 UQ 把模型当作"一次性问答器"——你问一次,它答一次,你估计它答对没有。但 Agent 是"持续对话者"——它在多轮交互中不断获取新信息、调整策略、做出决策。这意味着不确定性不是静态标量,而是随交互动态演化的过程量。论文中那个"失败轨迹不确定性反而下降更快"的发现尤其发人深省:一个自信地走向错误的 Agent,比一个犹豫不决但方向正确的 Agent 更危险。这启示我,好的不确定性估计不仅要反映"模型有多不确定",更要反映"不确定性是否在朝着正确的方向变化"。
第二层启示是关于异构性的处理。 Agent 轨迹中的动作不确定性("该不该调用这个 API?")和观测不确定性("环境返回的结果可靠吗?")本质上是不同类型的问题。把它们统一在一个数学框架下是理论上的优雅,但工程上可能需要不同的估计策略——动作不确定性更多依赖模型自身置信度,观测不确定性更多依赖环境模型的质量。
第三层启示是关于安全护栏的实践路径。 论文提到医疗、编程、机器人三个应用场景,核心思路是一致的:用 UQ 作为人机协作的切换信号——低不确定性时 Agent 自主执行,高不确定性时交给人类。这比简单的"置信度阈值"要深刻,因为它考虑的是轨迹级别的不确定性累积,而非单步置信度。在工程实践中,我认为可以先用语言化置信度(尽管无理论保证)做 MVP——实验显示它在某些场景表现最好,且几乎零额外开销。
局限性也很明显:论文的实验仅在 τ²-bench 两个场景上做了,泛化性存疑;提出的框架偏理论,没有给出可即用的算法;对"不确定性动态"的讨论停留在现象描述层面,解决方案指向了 Appendix E 但未深入。但作为一篇 position paper,它成功地把 Agent UQ 从"没人想过的问题"变成了"必须系统研究的问题"——这本身就是最大的贡献。
参考资源
- 论文原文:arXiv:2602.05073
- 项目页面:https://agentuq.github.io/
- 实验数据:HuggingFace: tau2-uq-artifacts
- τ²-bench 基准:GitHub: sierra-research/tau2-bench
标签:#AI解读 #不确定性量化 #LLM Agent #Agent 安全