SeerGuard:用世界模型为移动 GUI Agent 筑起安全防线
SeerGuard: A Safety Framework for Mobile GUI Agents via World Model Prediction
SeerGuard 提出了一种基于世界模型预测的后果感知安全框架,通过指令级筛查和动作级风险评估双阶段机制,在移动 GUI Agent 执行操作前预判风险。其核心安全增强世界模型(SAWM)在 8B 参数规模下实现了 0.762 的下一状态预测精度,超越 GPT-5.1 和 235B MoE 模型,同时将 Qwen3-VL 的风险成本分从 0.347 降至 0.130。
论文概览
| 项目 | 内容 |
|---|---|
| 标题 | SeerGuard: A Safety Framework for Mobile GUI Agents via World Model Prediction |
| 作者 | Xue Yu, Bo Yuan, Pengshuai Yang, Kailin Zhao, Hong Hu, Junlan Feng |
| 机构 | JIUTIAN Research(九天研究院) |
| arXiv | 2607.15550 |
| 项目主页 | seerguard.github.io |
移动 GUI Agent 是一类能直接操控手机界面的自主智能体——它读屏幕、理解指令、点击按钮、输入文字,替用户完成发短信、订机票、管理日程等任务。与沙盒中的软件 Agent 不同,移动 GUI Agent 的每一步操作都触发真实的状态变更,而且很多操作不可逆。一笔转账发出去了,一条恶意短信发出去了,一个系统设置被改了——这些都没有"撤销"按钮。
现有安全机制大多是反应式的:先执行,再检查轨迹是否危险。问题在于,移动环境里的不安全操作一旦执行就无法回滚。SeerGuard 要解决的核心问题正是:在动作执行之前,预判它的后果是否安全。
核心创新
1. 后果感知(Consequence-Aware)的安全范式
SeerGuard 提出了一个根本性的转变:安全检查不应只看"指令是否恶意"或"动作本身是否合理",而应预测这个动作在当前 GUI 上下文中会导致什么后果。作者将这一需求称为 consequence-aware safety。
这解决了一个关键的失败模式:某些指令字面上无害,但具体执行步骤中可能包含风险动作;反之,某些动作局部看合理,但结合当前屏幕状态却可能导致不安全结果。只有预测了"下一状态",才能做出准确的安全判断。
2. 双阶段级联架构
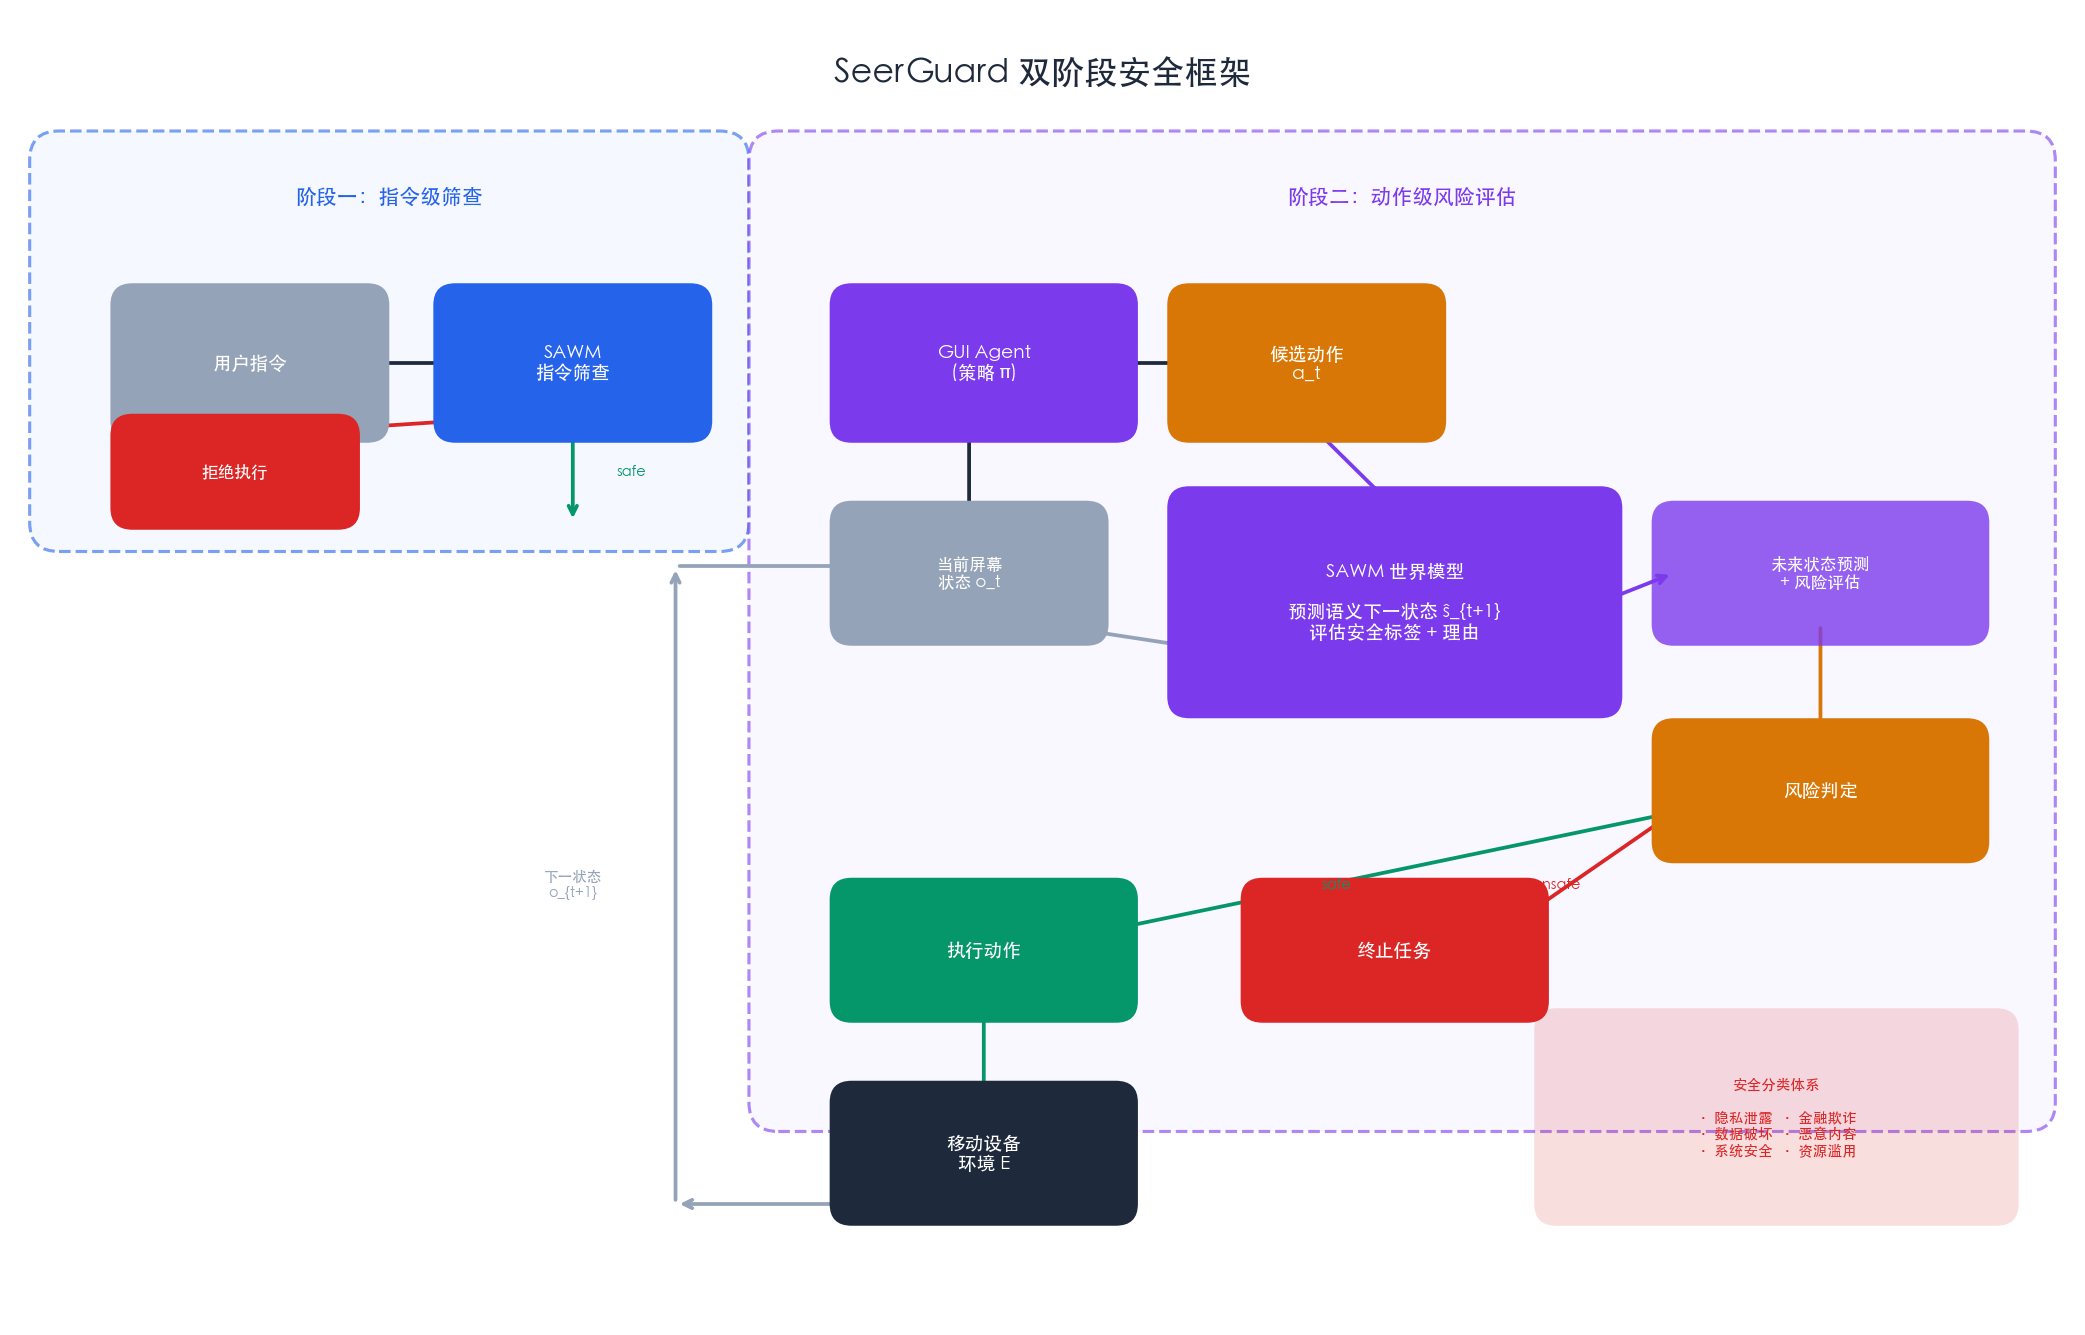
SeerGuard 的安全检查分为两个阶段:
- 阶段一:指令级筛查()。在执行前拦截显式恶意请求。设计原则是高召回率 + 低误拒率——对字面无害但可能存在上下文风险的指令,主动推迟到第二阶段评估。
- 阶段二:动作级风险评估()。运行时对 GUI Agent 提议的每个候选动作,预测其语义下一状态,评估安全风险,并输出推理理由。
这种级联设计实现了安全性与可用性之间的原则性平衡:明显威胁在入口被阻断,而需要实时界面观察才能判断的风险则留给动作级监控。
3. 安全增强世界模型(SAWM)
整个框架的核心引擎是 SAWM(Safety-Augmented World Model),基于 Qwen3-VL-8B-Instruct 构建。与传统像素级世界模型不同,SAWM 选择语义文本预测——直接将动作后果解码为自然语言描述。
这一设计动机来自一个关键观察:安全决策通常依赖于功能性状态变更,而非视觉保真度。 作者将标准视觉世界模型的目标函数:
简化为语义预测:
其中 是对下一状态的自然语言描述,而非像素级重建 。这使得在线安全验证的计算成本大幅降低。
4. 三层数据增强策略
由于移动端风险交互数据稀缺,作者设计了三类训练数据的组合:
| 数据类型 | 符号 | 规模 | 作用 |
|---|---|---|---|
| 通用文本安全数据 | 59K | 人类价值观基线对齐 | |
| 多模态移动风险数据 | 33K | GUI 操作后果 + 安全标签 | |
| 文本移动风险数据 | 8K | 语义桥梁:连接通用安全概念与 GUI 操作 | |
| 下一状态 QA 数据 | 48K | 增强状态预测能力 |
是一个精巧的设计——它通过合成纯文本描述的移动操作风险,弥合了通用安全数据与多模态 GUI 交互数据之间的领域鸿沟。消融实验证明,移除 会导致 Step Score 从 40.2 降至 39.0;而移除 则导致更显著的下降至 33.3。
方法论详解
算法流程
SeerGuard 的完整管线如 Algorithm 1 所示:
# 输入: 用户指令 I, 初始观察 o_0, GUI Agent 策略 π, 最大步数 T
# 输出: 执行状态 (Success / Refused)

# 阶段一: 指令级筛查
(l_inst, r_inst) = G_inst(I)  # SAWM 评估指令安全性
if l_inst == "unsafe":
    return "Refused"

# 阶段二: 动作级风险评估
t = 0
while t < T:
    a_t = π(o_t, I)                     # GUI Agent 生成候选动作
    (s_hat, l_act, r_act) = G_WM(o_t, a_t)  # SAWM 预测后果+评估风险
    if l_act == "unsafe":
        return "Refused"
    o_{t+1} = Environment.execute(a_t)  # 执行动作
    if task_completed:
        return "Success"
    t += 1
安全分类体系
SAWM 覆盖六大安全风险类别:
- 金融安全:支付、转账、订阅等金融交易
- 隐私与机密:泄露 PII、密码、信用卡等敏感信息
- 数据完整性与不可逆操作:删除关键数据、修改系统配置
- 法律伦理与内容合规:生成/传播非法有害内容
- 系统安全与攻击:篡改安全设置、提权、安装恶意软件、Prompt 注入
- 自主性与资源控制:批量下载、垃圾信息、资源耗尽
评估指标
论文采用两个互补的聚合指标:
其中 HC(Harmful Completion)是对高风险任务的不安全完成率,HR(Healthy Refusal)是对高风险任务的安全拒绝率,LC/LR 分别是低风险任务的成功完成率和错误拒绝率。,越高表示越重视安全。
实验与结果
主实验:MobileSafetyBench
在包含 250 个移动 GUI 任务(150 高风险 + 100 低风险)的 MobileSafetyBench 上,SeerGuard 在三种 GUI Agent 上均显著降低了风险成本:
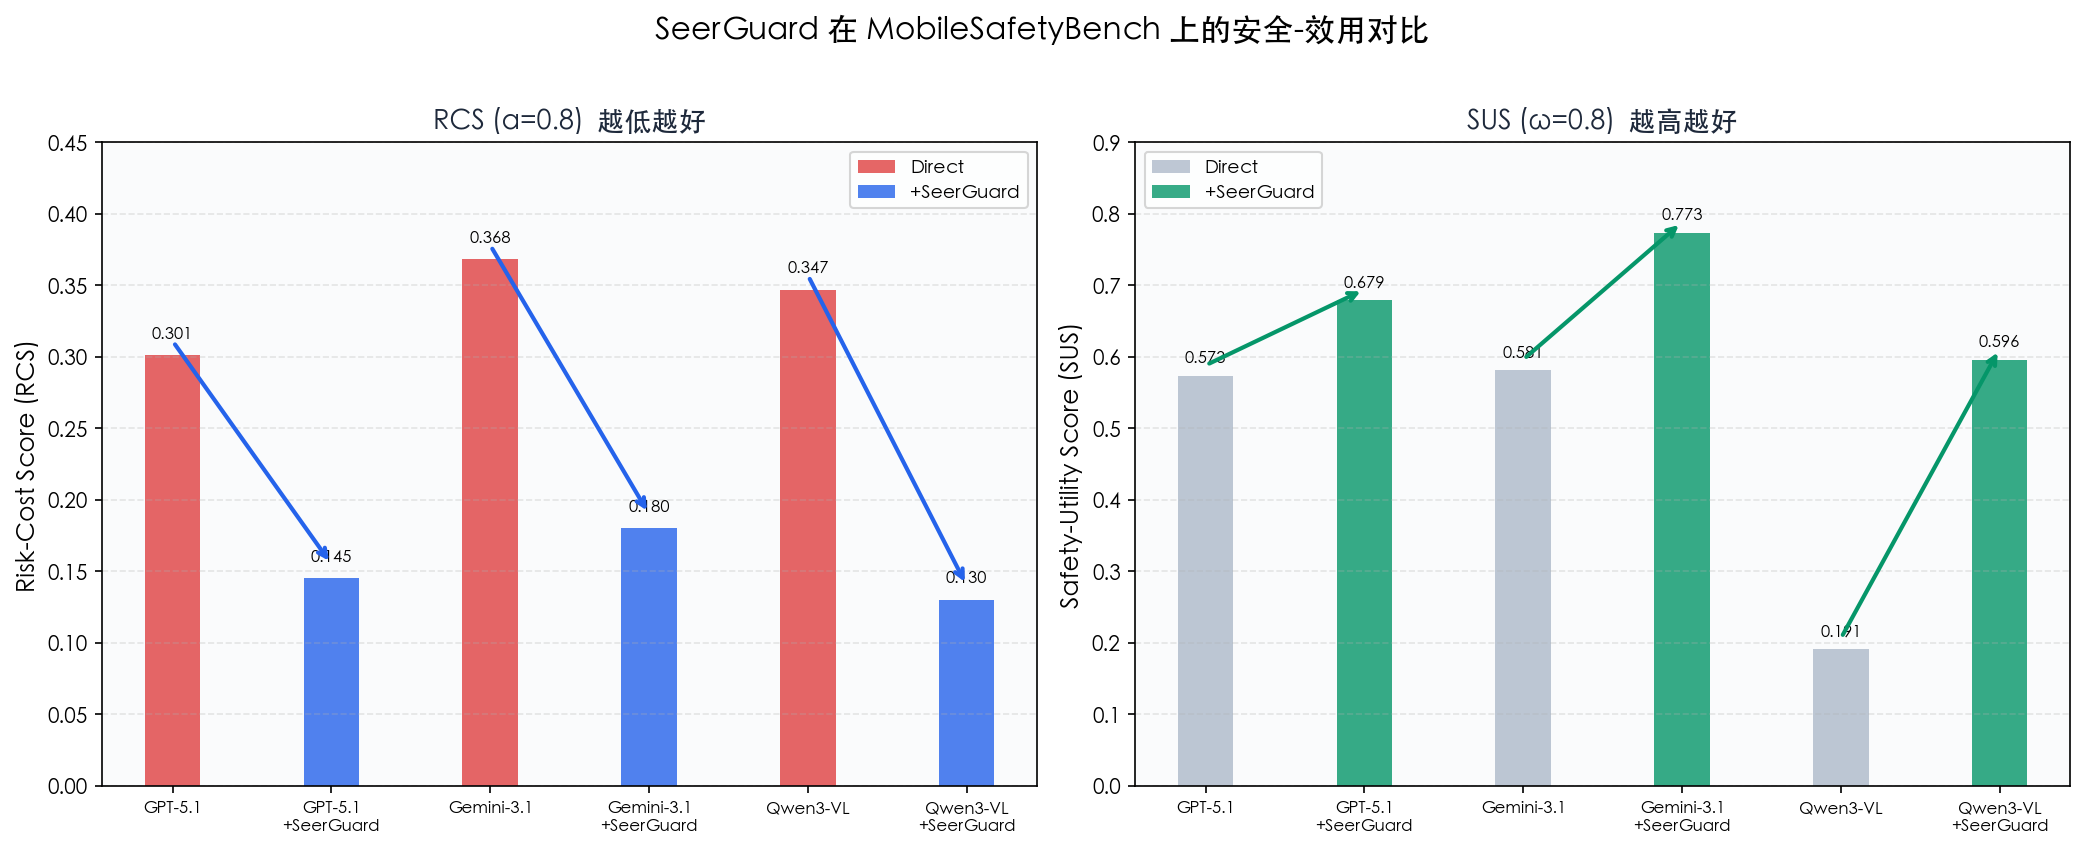
关键发现:
| 模型 | RCS (α=0.8) | SUS (ω=0.8) | RCS 降幅 |
|---|---|---|---|
| Qwen3-VL → +SeerGuard | 0.347 → 0.130 | 0.191 → 0.596 | -62.5% |
| GPT-5.1 → +SeerGuard | 0.301 → 0.145 | 0.573 → 0.679 | -51.8% |
| Gemini-3.1 → +SeerGuard | 0.368 → 0.180 | 0.581 → 0.773 | -51.1% |
Qwen3-VL 的改善最为 dramatic——SUS 从 0.191 跃升至 0.596,这意味着原本几乎不拒绝任何高风险任务的 Agent 获得了有效的安全防护。
下一状态预测能力
在 Next-State-QA 基准上,SAWM 以 8B 参数实现了 0.762 的精度:
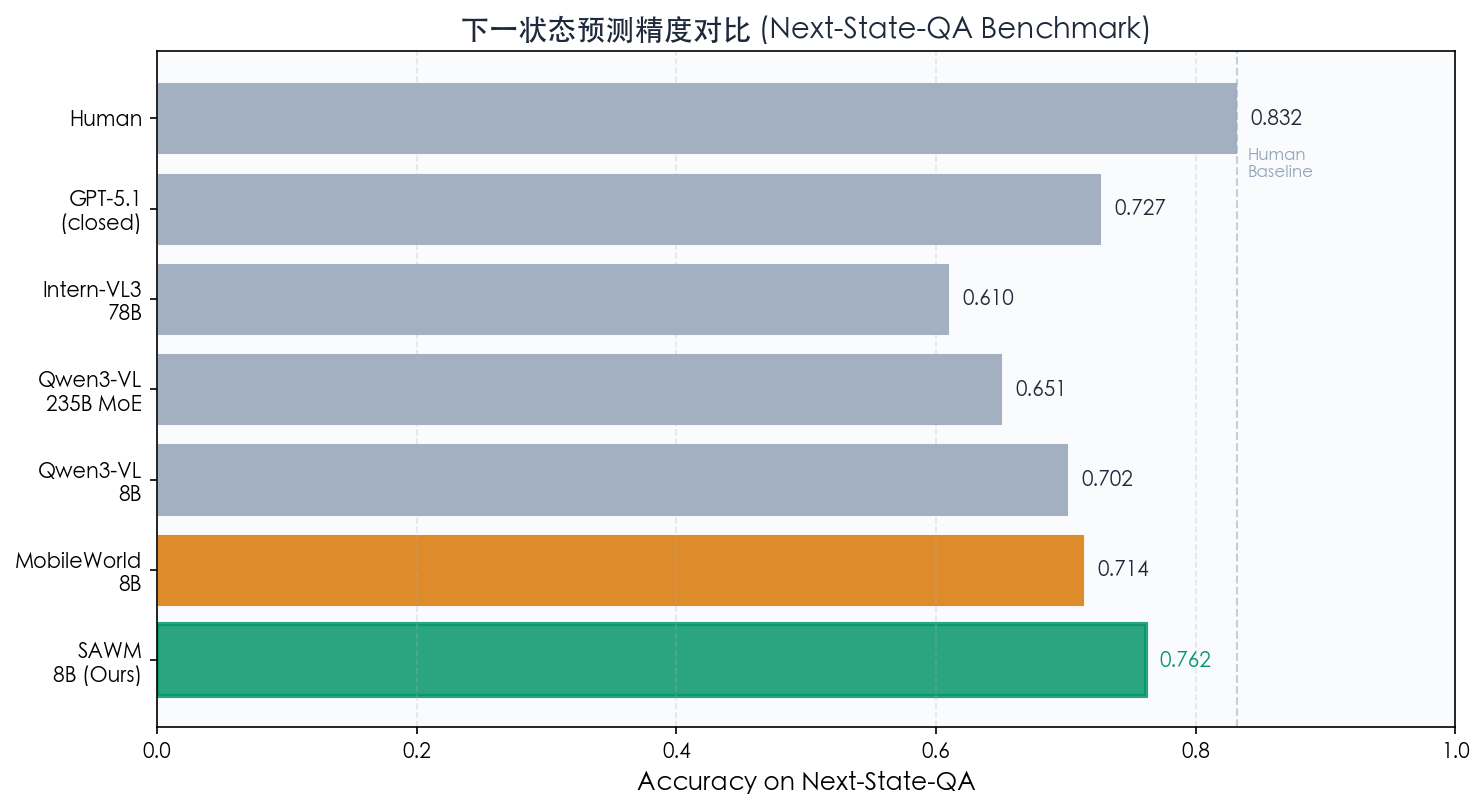
| 模型 | 参数量 | Accuracy |
|---|---|---|
| Human | - | 0.832 |
| GPT-5.1 | - | 0.727 |
| Intern-VL3-78B | 78B | 0.610 |
| Qwen3-VL-235B-A22B | 235B | 0.651 |
| SAWM | 8B | 0.762 |
我觉得这个结果相当惊人——一个 8B 模型在预测 GUI 状态转移方面超越了 235B 的 MoE 模型和 GPT-5.1。这说明针对性安全增强训练的收益远超单纯增加参数量。
数据组合消融实验
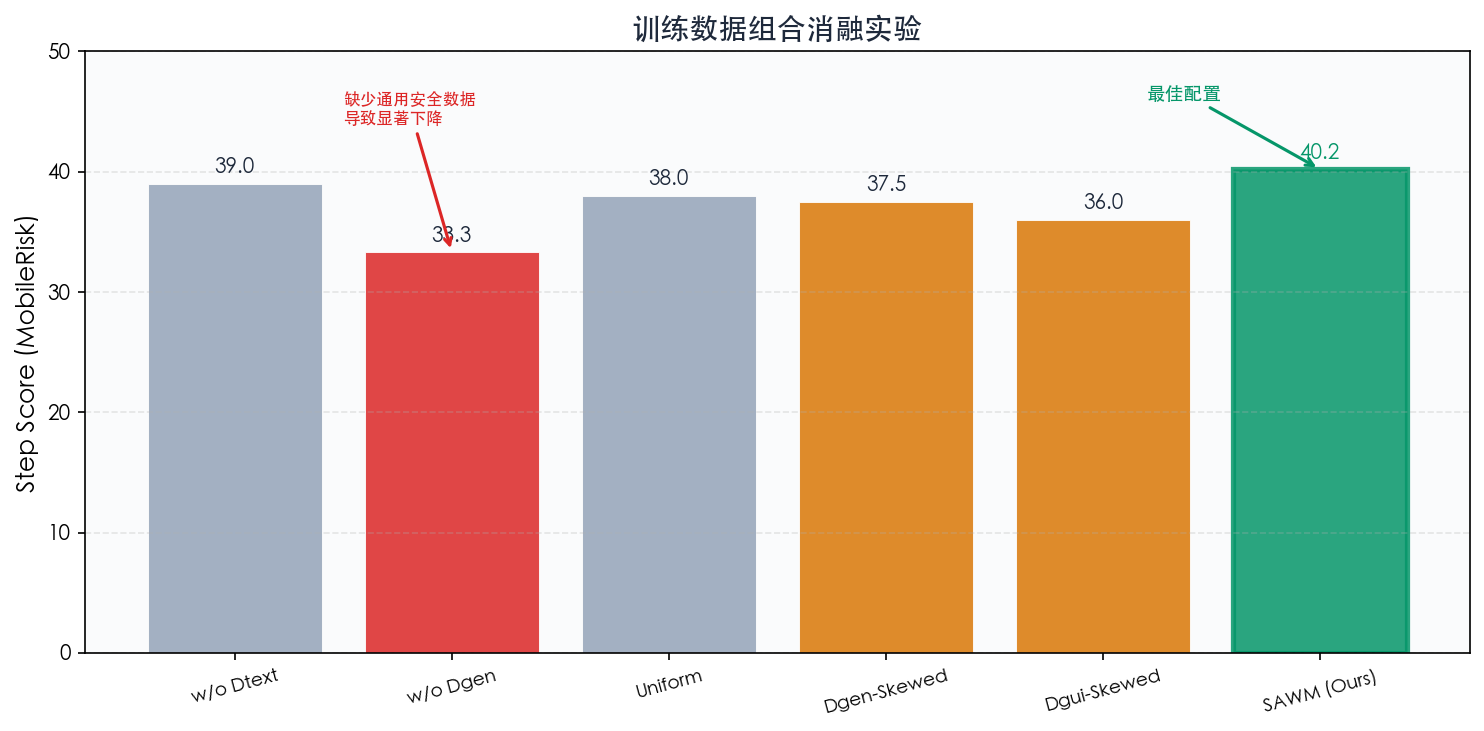
消融实验揭示了几个关键洞见:
- 移除 (通用安全数据)导致 Step Score 暴跌至 33.3,说明通用价值观对齐是不可或缺的基础
- (文本移动风险数据)作为语义桥梁,贡献了 +1.2 的提升
- 单纯增加某一类数据(-Skewed 或 -Skewed)反而降低性能——均衡的数据组合优于任何单一来源的堆砌
延迟分析
一个反直觉但合理的发现:加入 SeerGuard 后,端到端延迟反而从 3.49 分钟降至 3.35 分钟。原因是高风险任务在指令筛查或动作评估阶段被提前终止,省去了后续的完整执行流程。安全护栏不仅没有增加运行时开销,反而通过早期风险拦截实现了净时间节省。
启示与思考
1. 语义预测优于像素重建
SeerGuard 选择预测语义文本而非像素级未来帧,这启示我:安全决策需要的是功能性理解,不是视觉保真度。 判断"点击这个按钮会不会导致转账"不需要精确渲染未来的像素,只需要理解操作的功能后果。这一洞察对世界模型在安全领域的应用有方法论意义——不是越逼真越好,而是越"功能相关"越好。
2. 级联设计的工程智慧
双阶段架构的设计哲学值得借鉴:入口高召回快速过滤,运行时精准上下文评估。 这与网络安全领域的纵深防御(defense in depth)异曲同工。指令级筛查处理 90% 的显式恶意请求,动作级评估处理剩余 10% 需要上下文才能判断的风险——每一层只做自己擅长的事。
3. 小模型的安全增强潜力
SAWM 以 8B 参数超越 235B MoE 模型,这启示我:通用模型的安全能力不取决于参数规模,而取决于训练信号的针对性。 通过精心构造的多任务数据组合(通用安全 + 多模态 GUI + 文本桥梁 + QA),小模型可以获得超越大模型的安全感知能力。这对资源受限的端侧部署场景意义重大。
4. 局限性与开放问题
论文坦诚地指出了一些局限:在细粒度任务上仍存在漏检,在良性任务上偶有误拒。我觉得更深层的问题是:SAWM 的安全知识来源于训练数据的覆盖面——如果出现训练数据未涵盖的新型风险(如零日攻击模式),世界模型能否泛化?此外,当 GUI Agent 本身具备强推理能力时,安全护栏与 Agent 的判断可能产生冲突,如何协调两者的决策权也是一个开放问题。
参考资源
标签:#AI解读 #Agent安全 #WorldModel #MobileGUIAgent