Lean4Agent:用依赖类型形式语言建模与验证 Agent 工作流
Lean4Agent: Formal Modeling and Verification for Agent Workflow and Trajectory
UIUC 团队提出首个使用 Lean4 依赖类型形式语言统一建模和验证 LLM Agent 工作流与执行轨迹的框架。三层验证库 FormalAgentLib(151 类型、611 函数、41 定理)配合 LeanEvolve 工作流演化,在 SWE-Bench 和 ELAIP-Bench 上验证通过的工作流平均优于失败的 11.94%,LeanEvolve 额外提升 7.47%。
论文概览
标题: Lean4Agent: Formal Modeling and Verification for Agent Workflow and Trajectory
作者: Ruida Wang, Jerry Huang, Pengcheng Wang (UIUC); Xuanqing Liu, Luyang Kong (Independent); Tong Zhang (UIUC)
链接: arXiv:2606.06523 | 代码: github.com/RickySkywalker/Lean4Agent
核心问题: LLM Agent 在高风险领域部署时,工作流规范和执行轨迹都缺乏形式化验证手段。现有方法——LLM-as-judge 易受幻觉影响、Hoare-style 契约仅验证工具调用、SMT 无法表达高阶推理、时序逻辑无法建模数据依赖——各自为政,没有统一框架。
核心方案: 受数学中依赖类型理论(dependent type theory)形式化证明的启发,Lean4Agent 首次将 Lean4 这一表达性依赖类型形式语言应用于 Agent 行为的建模与验证。
核心创新
1. FormalAgentLib:三层 Lean4 验证库
这是论文的核心贡献——一个包含 151 个类型、611 个函数和 41 个定理的可扩展 Lean4 库,从三个层次验证 Agent 工作流:
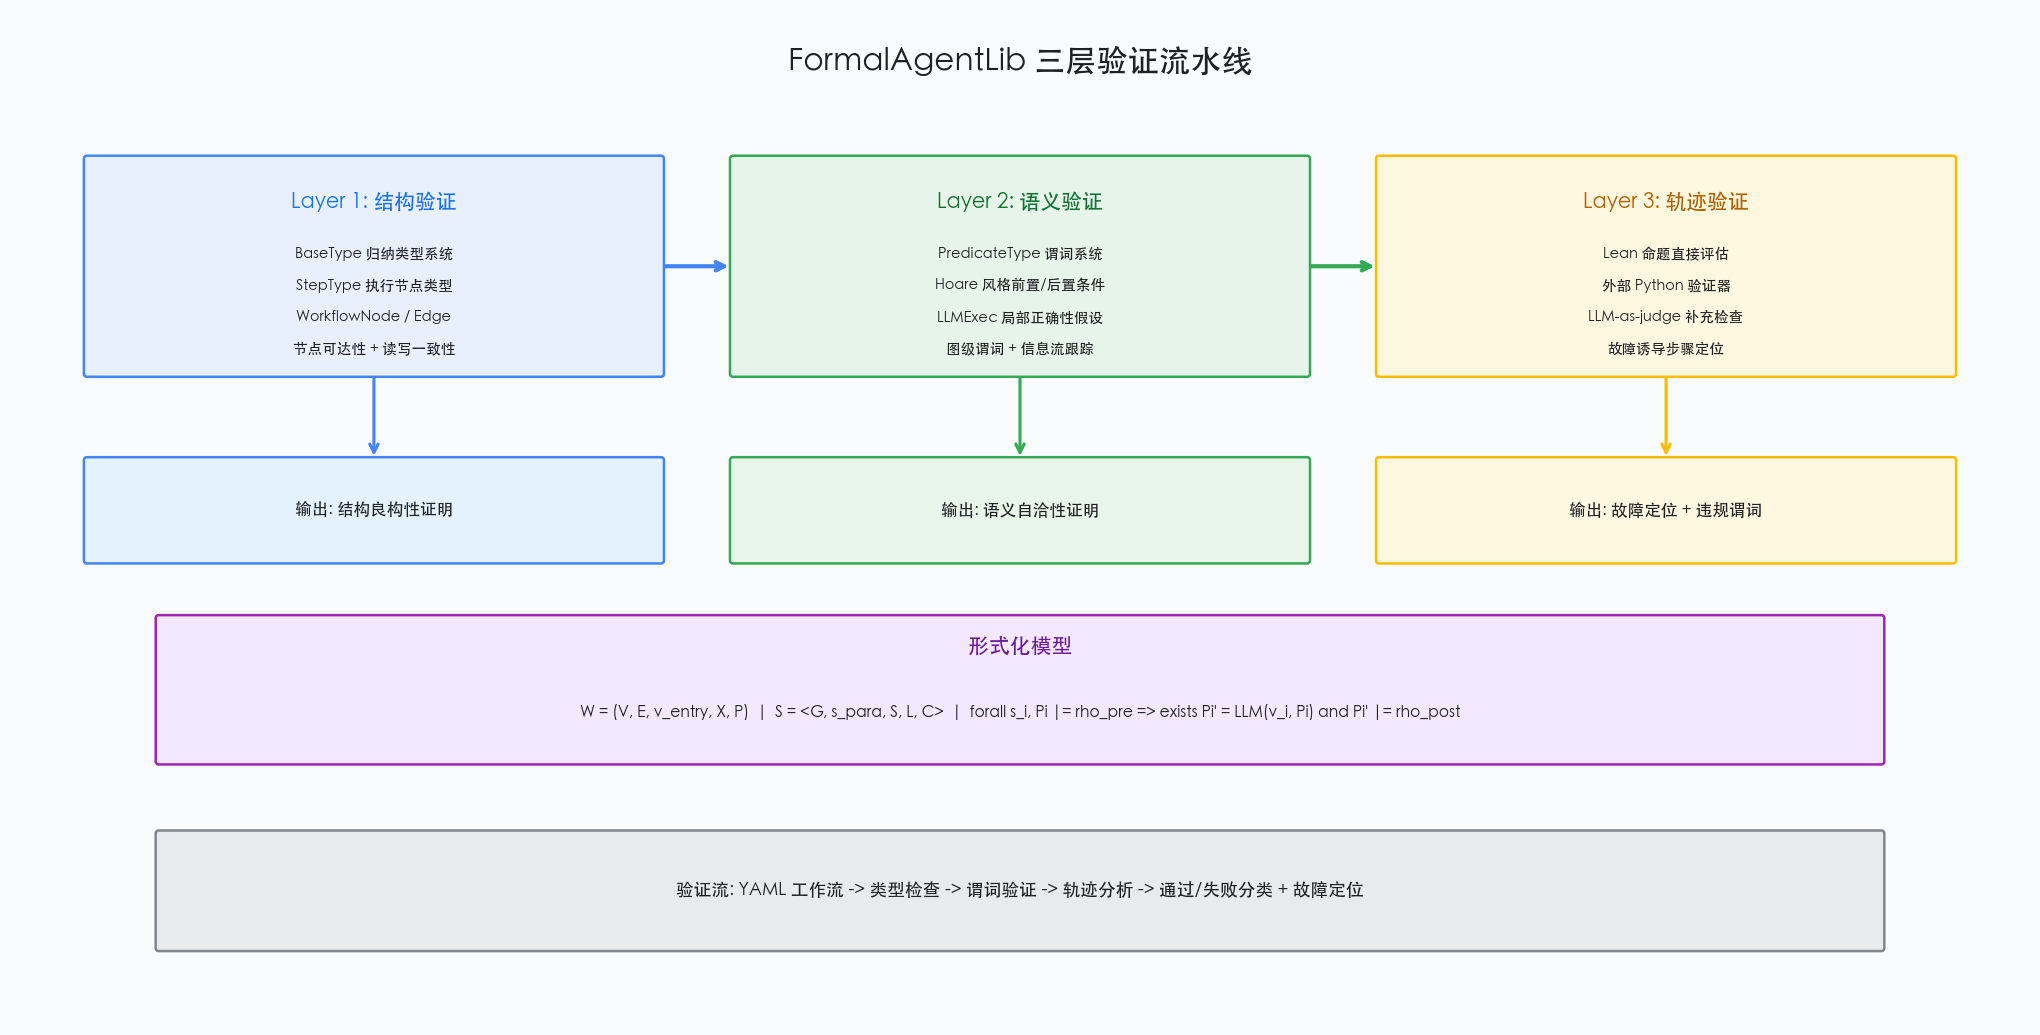
Layer 1 — 结构验证:定义 BaseType(归纳类型系统)、StepType(执行节点类型)、WorkflowNode 和 WorkflowEdge,验证工作流的结构良构性——类似于编译器级检查。可以检测节点读取了既非初始参数也非由可达前驱产生的变量时的读不一致错误。
工作流形式化模型为:
其中 和 是类型化节点和边的有限集合, 是入口节点, 是出口节点集合, 是初始参数列表。
Layer 2 — 静态语义验证:引入谓词系统(PredicateType),将每个 LLM 步骤约束为 Hoare 风格的前置/后置条件对。核心验证公式为:
其中 是当前谓词上下文, 假设认为 LLM 能很好执行短时程任务。这层还引入了图级谓词——信息流谓词跟踪每步消费和产生哪些信息,上下文管理谓词指定步骤可观察哪些先前上下文。
Layer 3 — 执行轨迹验证:检查 LLMExec 假设在特定轨迹上是否成立。对基本谓词直接用 Lean 命题评估;对 Lean 无法判定的谓词(如 URL 连通性)使用外部 Python 验证器;对仅有自然语言定义的变量使用 LLM-as-judge。最终定位故障诱导步骤。
2. LeanEvolve:形式化引导的工作流演化
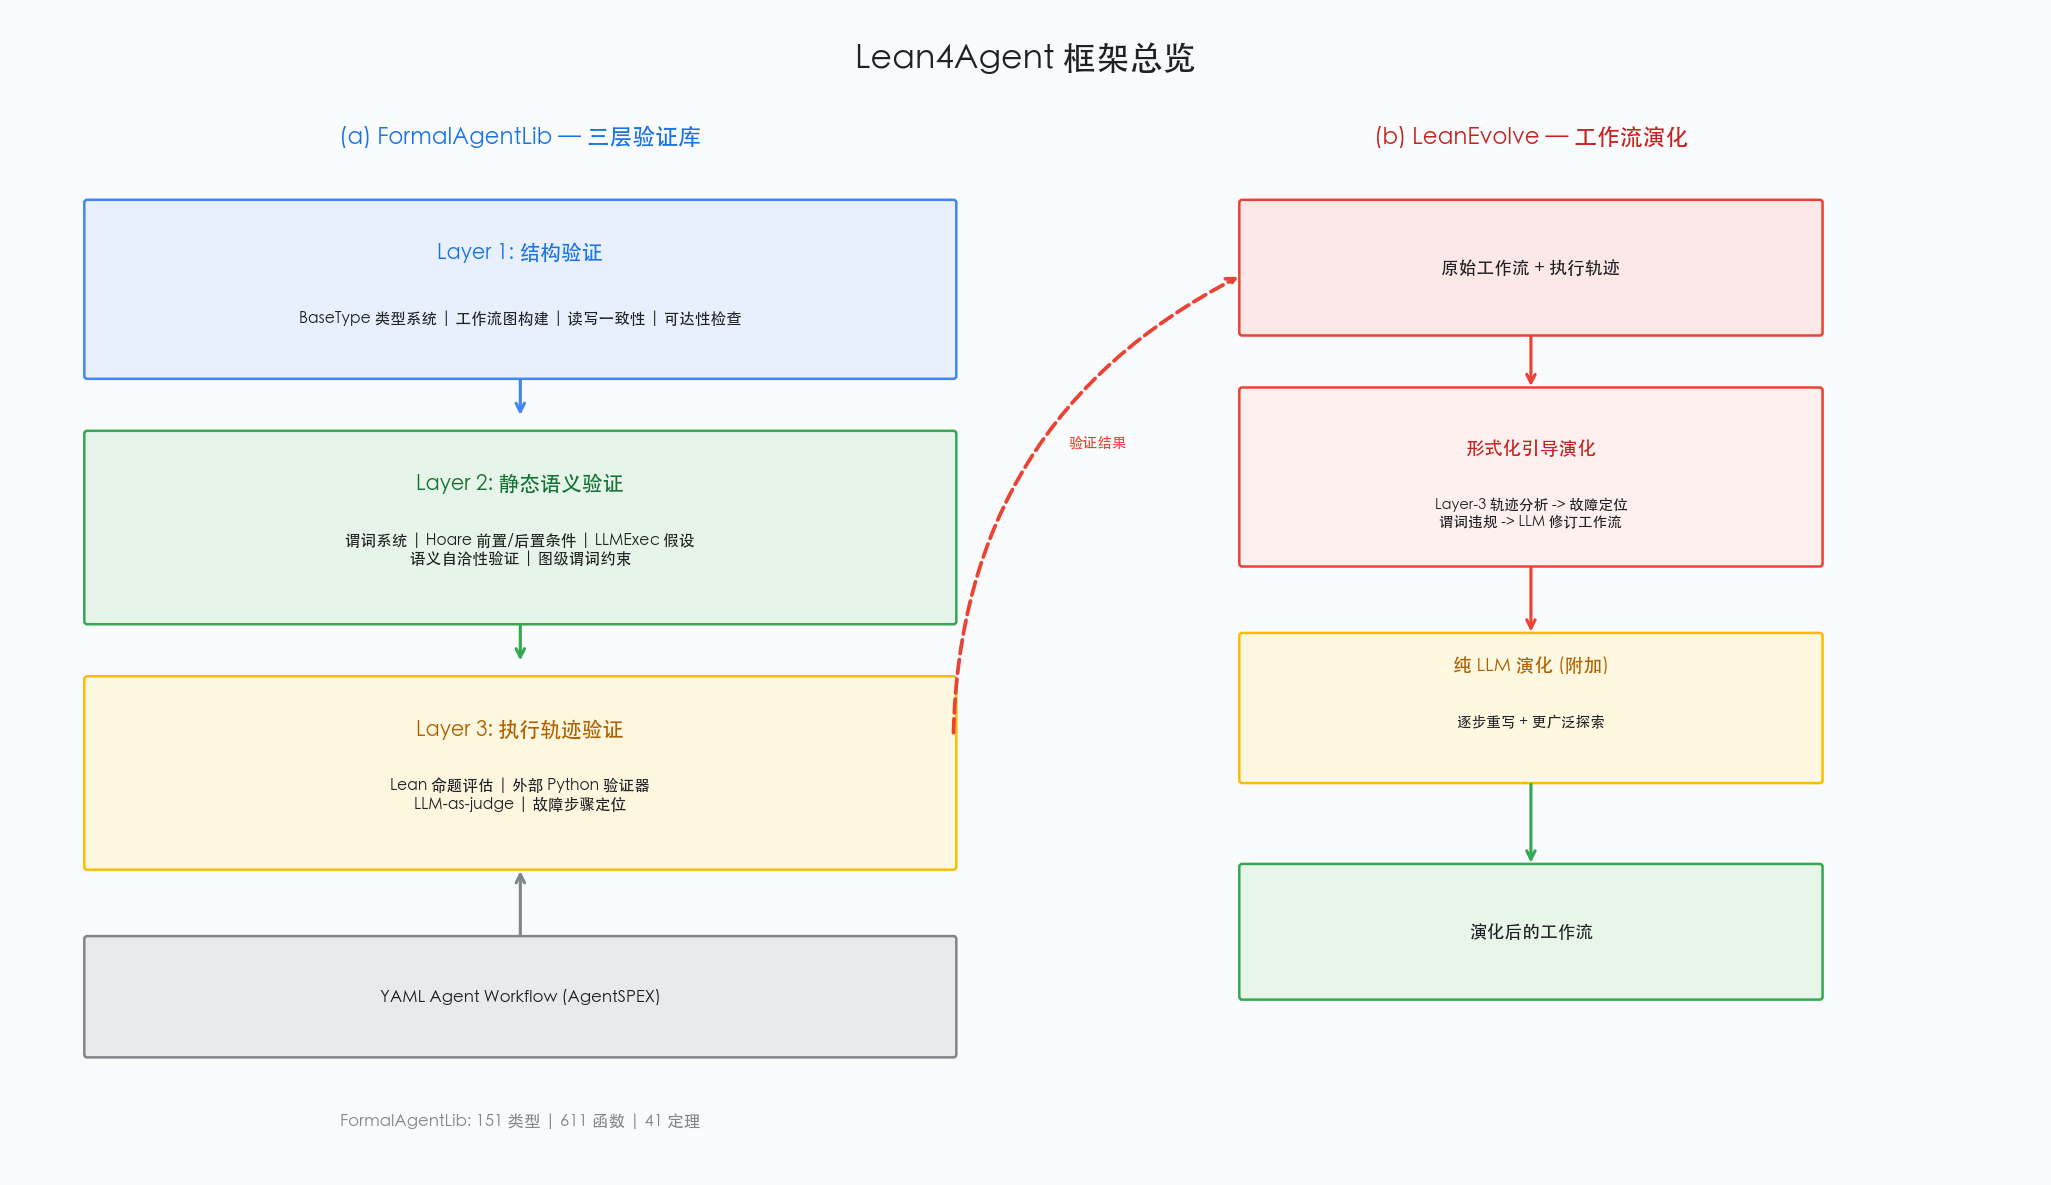
LeanEvolve 包含两种模式:
- 形式化引导演化:利用 Layer-3 的轨迹分析定位故障步骤和被违反的谓词,将此信息提供给 LLM 修订工作流相应部分
- 纯 LLM 演化(附加):针对允许多次尝试的任务,用轨迹和环境反馈逐步重写工作流,无需形式化引导
消融实验表明形式化引导演化是主要驱动因素——移除纯 LLM 演化后,平均提升从 7.47% 降至 5.07%。
3. 将数学范式迁移到 Agent 验证
论文最深刻的洞察在于范式类比:数学中自然语言的模糊性促使了依赖类型形式语言(Lean、Coq)的发展,同样地,Agent 系统中自然语言规范的模糊性也应该用形式语言来消除。这不是简单的工程优化,而是一种方法论选择——用表达性类型理论统一建模工作流规范和执行轨迹。
方法论详解
核心数据结构
论文定义了一套完整的 Lean4 类型系统来建模 Agent 工作流:
| 类型 | 作用 | 关键构造子 |
|---|---|---|
BaseType | 变量类型系统 | TUnit, TString, TInt, TFloat, TBool, TJson, TList, TDict, TRecord, TUnknown |
StepType | 执行节点类型 | step(带对话历史), task(无对话历史), forEachLoop, conditional, parallel, call, synthesize 等 |
WorkflowNode | Agent 步骤建模 | id, name, stepType, reads, writes, llmInstruction |
WorkflowEdge | 节点转移模式 | seqEdge, branchEdge, loopEdge, forkEdge, joinEdge, switchEdge |
WorkflowGraph | 完整工作流 | nodes, edges, entry, exits, parameters |
谓词系统设计
谓词系统是 Layer 2 的核心,包含四类谓词:
- 基本谓词:如
matchesJsonSchema(验证变量是否符合 JSON schema) - 扩展谓词(
ext):支持任务特定谓词,与PredicateKey关联 - 自定义谓词(
custom):对无清晰定义的谓词建模,包含变量名存在性验证和 NL 解释 - 图级谓词:隐式变量和信息流谓词,跟踪每步消费和产生哪些信息
消融实验表明,40 个工作流中 21 个未通过完整 Layer-2 验证,但移除图级谓词后仅 8 个仍失败——许多缺陷仅由图级约束检测到。
实验结果
实验设置
- 任务 1: SWE-Bench-Verified 难题子集(50 个,从 500 个中随机选取)
- 任务 2: ELAIP-Bench 子集(100 个问题,从 403 个中随机选取)
- 评估模型: GPT-5.2, GLM-5, Kimi-K2.5, Gemma-4-31B, Qwen-3.5-27B
- Lean 版本: v4.20.0
- 工作流执行引擎: AgentSPEX(温度 1.0,上下文长度 163,840)
主要结果:验证通过 vs 失败
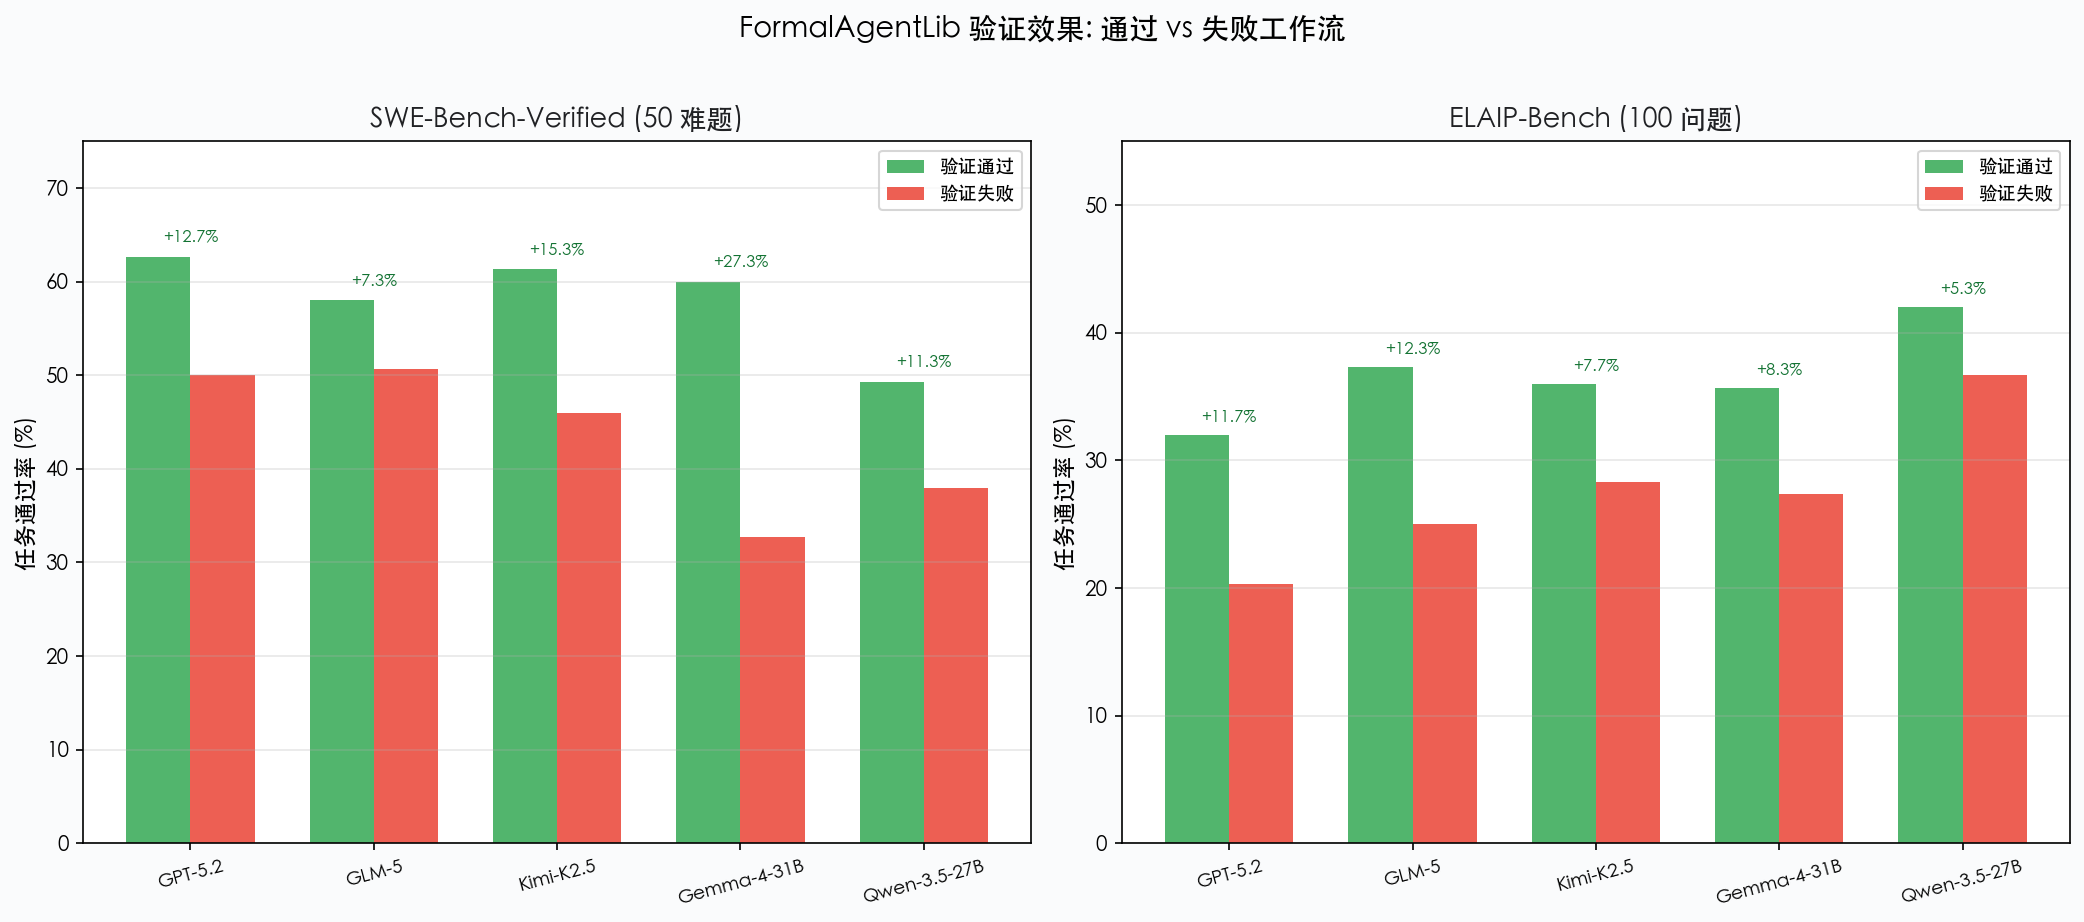
| 模型 | SWE 差值 | ELAIP 差值 |
|---|---|---|
| GPT-5.2 | +12.67% | +11.67% |
| GLM-5 | +7.33% | +10.83% |
| Kimi-K2.5 | +15.33% | +7.67% |
| Gemma-4-31B | +27.33% | +8.34% |
| Qwen-3.5-27B | +11.33% | +5.33% |
| 平均 | +14.80% | +9.07% |
一个值得注意的发现:较小模型的增益通常更大(Gemma-4-31B 在 SWE 上差值达 27.33%),表明较弱的 agent 对工作流质量更敏感。
LeanEvolve 提升效果
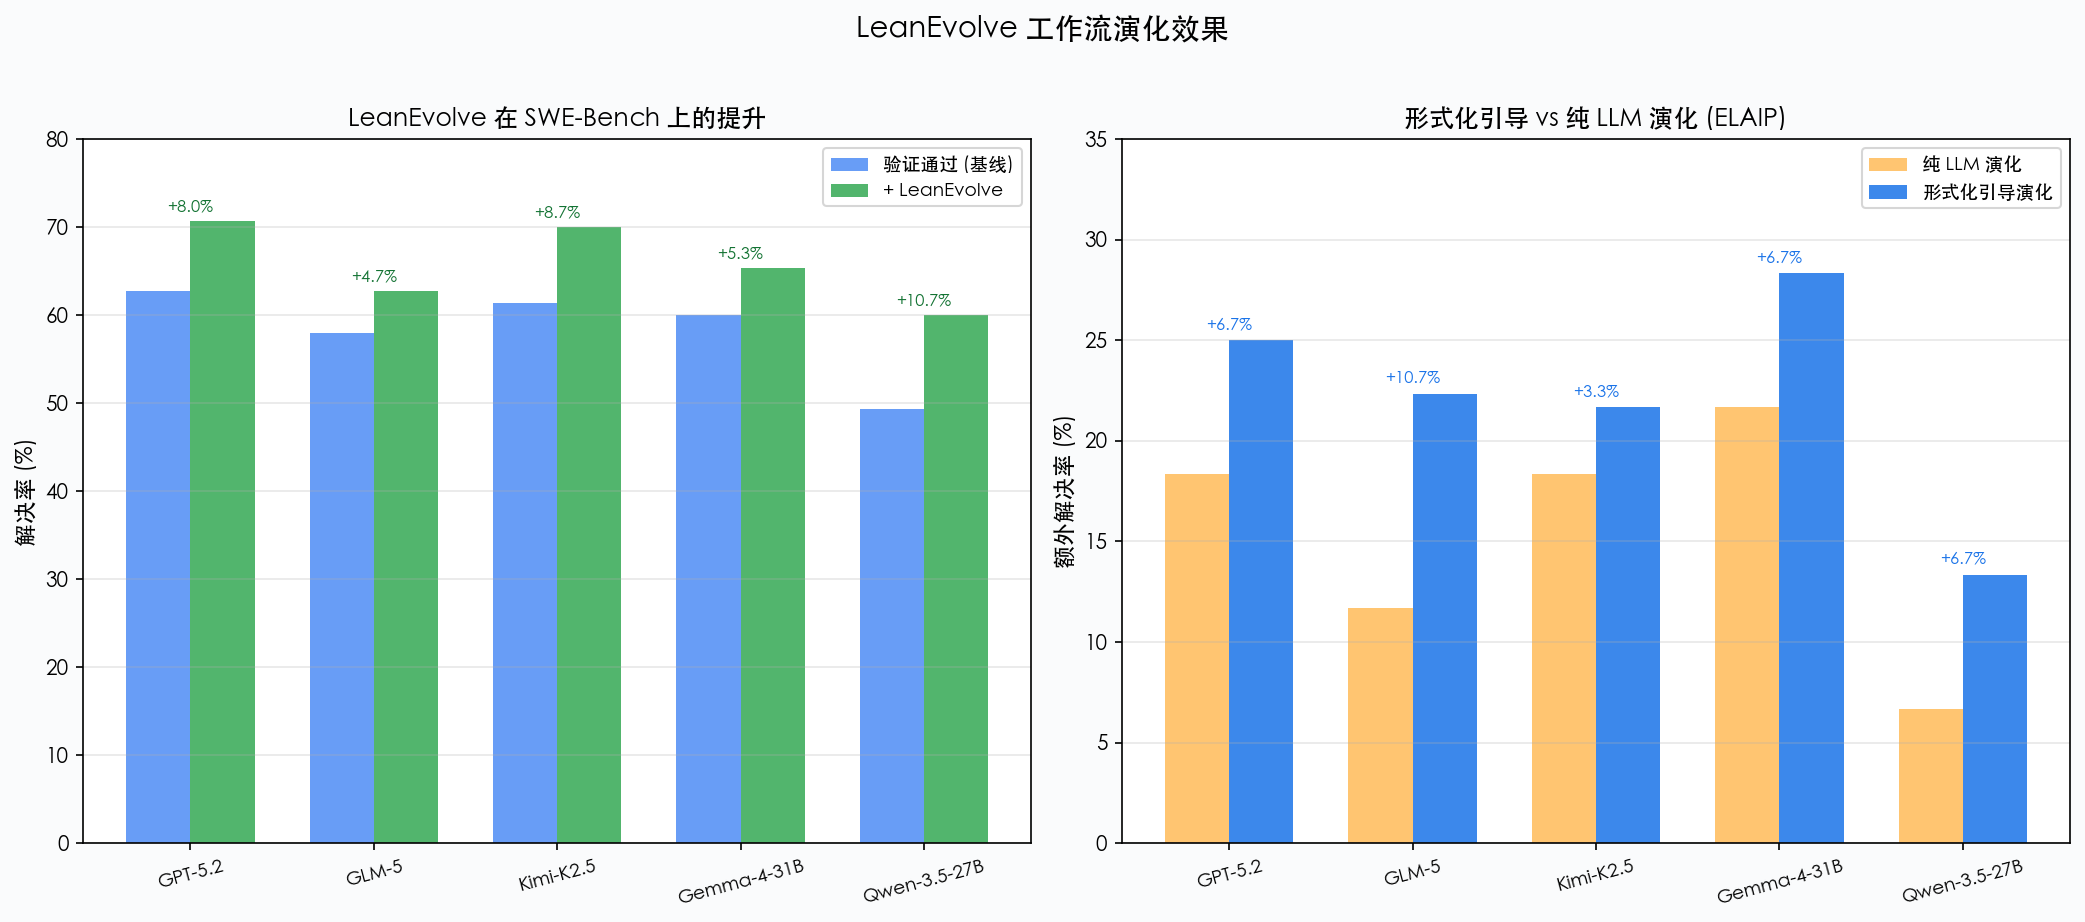
| 模型 | SWE 额外解决 | 总体解决率 |
|---|---|---|
| GPT-5.2 | +8.00% | 70.67% |
| GLM-5 | +4.67% | 62.67% |
| Kimi-K2.5 | +8.67% | 70.00% |
| Gemma-4-31B | +5.33% | 65.33% |
| Qwen-3.5-27B | +10.67% | 60.00% |
| 平均 | +7.47% | 56.93% → 64.40% |
形式化引导演化比纯 LLM 演化平均多解决 7.00% 的初始失败案例。
LLM-as-judge 对比
在论文理解任务上,LLM judge 与 FormalAgentLib 验证大致一致;但在 SWE 任务上,LLM 判断与 Lean 验证和实际性能一致性较弱——LLM judge 通常只捕获显式工作流行为,遗漏隐式信息流和图级谓词约束。这直接印证了形式化验证的不可替代性。
关键数据汇总
| 维度 | 数据 |
|---|---|
| FormalAgentLib 规模 | 151 类型, 611 函数, 41 定理 |
| 验证通过 vs 失败(平均) | +11.94% (SWE 14.80% + ELAIP 9.07%) |
| LeanEvolve 额外提升 | +7.47% (SWE) |
| 形式化引导 vs 纯 LLM 演化 | +7.00% |
| 评估模型数量 | 5 个领先 LLM |
| 95% CI (SWE 平均) | [10.00%, 19.60%] |
| 95% CI (ELAIP 平均) | [5.66%, 13.07%] |
启示与思考
对 AARM 框架的直接启示
Lean4Agent 的三层验证架构与 AARM 的三层设计(意图授权、执行隔离、副作用验证)存在结构对应关系。Layer 1 的结构验证对应工作流规范层面的检查,Layer 2 的语义验证对应执行隔离中的前置/后置条件,Layer 3 的轨迹验证则对应副作用验证。这种对应关系表明,依赖类型形式语言可以作为 AARM 框架的形式化底座。
LLMExec 假设的局限性
论文的核心假设 LLMExec——"LLM 通常能很好地执行短时程任务"——在简单场景下成立,但在对抗性输入或复杂推理链中可能失效。这正是 AgentMoss 的 PDG 污点分析可以补充的地方:通过检测低完整性数据是否控制高风险操作,可以在 LLMExec 假设不成立时提供额外的安全层。
图级谓词的价值
消融实验中最有价值的发现是图级谓词的不可替代性——许多工作流缺陷仅由图级约束(如信息流和上下文管理谓词)检测到,局部谓词无法建模这些工作流级一致性要求。这启示我们:仅靠单步验证是不够的,必须有跨步骤的信息流分析。
依赖类型 vs 其他形式化方法
论文选择 Lean4 而非 SMT 或时序逻辑的理由值得深思:依赖类型理论的表达能力足以统一建模数据依赖属性(时序逻辑做不到)和高阶推理(SMT 难以表达),同时通过 LLMExec 假设优雅地处理了 LLM 这一黑盒组件。这种设计选择为形式化验证 LLM Agent 提供了新的方法论范式。
局限性
论文承认 LLMExec 假设的局限,以及当前仅支持 AgentSPEX YAML 格式的工作流。扩展到更通用的 Agent 框架(如 LangGraph)需要额外的适配层。此外,Lean4 的学习曲线陡峭,FormalAgentLib 的 151 个类型和 611 个函数的人工编写成本不容忽视。
参考
- 论文: arXiv:2606.06523
- 代码: github.com/RickySkywalker/Lean4Agent
- Lean4: lean-lang.org
- AgentSPEX: Wang et al. 2026
- SWE-Bench-Verified: Jimenez et al. 2024
- ELAIP-Bench: Dai et al. 2025