形式不确定性的文法:何时信任 LLM 的自动推理
Grammars of Formal Uncertainty: When to Trust LLMs in Automated Reasoning Tasks
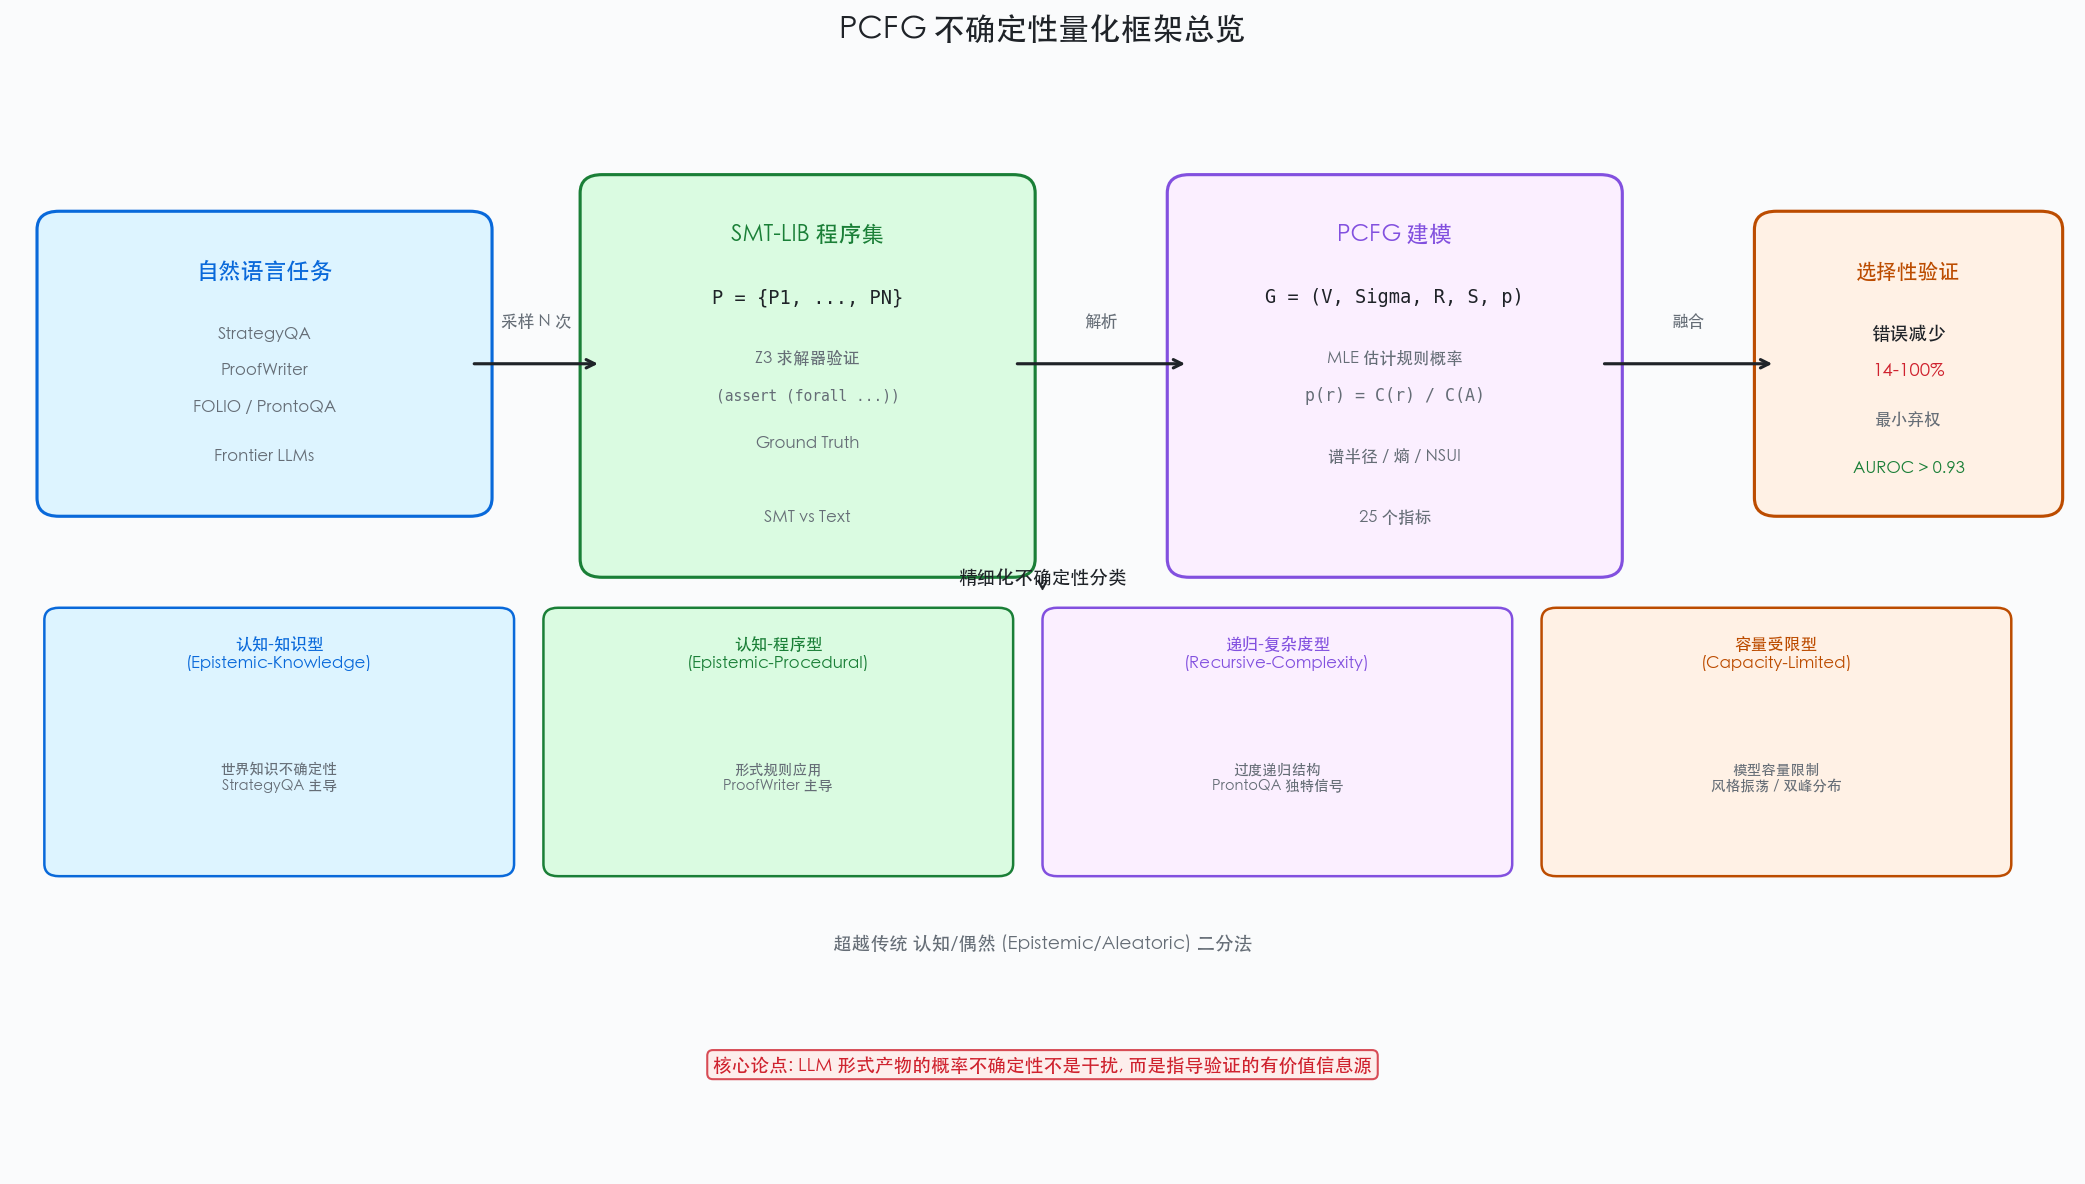
Case Western Reserve University 与 Microsoft 联合工作,首次用概率上下文无关文法(PCFG)建模 LLM 生成的 SMT-LIB 程序分布,提出 25 个不确定性指标和精细化四分类体系,实现选择性验证使错误率降低 14-100%。
论文概览
标题: Grammars of Formal Uncertainty: When to Trust LLMs in Automated Reasoning Tasks
作者: Debargha Ganguly, Vikash Singh, Sreehari Sankar, Biyao Zhang, Xuecen Zhang (Case Western Reserve University); Srinivasan Iyengar, Shivkumar Kalyanaraman (Microsoft Corporation); Amit Sharma (Microsoft Research); Xiaotian Han, Vipin Chaudhary (CWRU)
arXiv: 2505.20047
发布日期: 2025年5月26日
这篇论文击中了一个我长期思考的根本张力:LLM 是概率性的,而形式验证要求确定性保证。两者之间的认识论鸿沟不是工程问题,而是哲学问题。论文的核心论点是——LLM 在形式推理任务中输出的固有概率不确定性,特别是生成 SMT-LIB 程序等形式产物时,不是单纯的干扰,而是指导验证的有价值信息源。
核心贡献
1. 系统评估:SMT 自动形式化的双刃剑
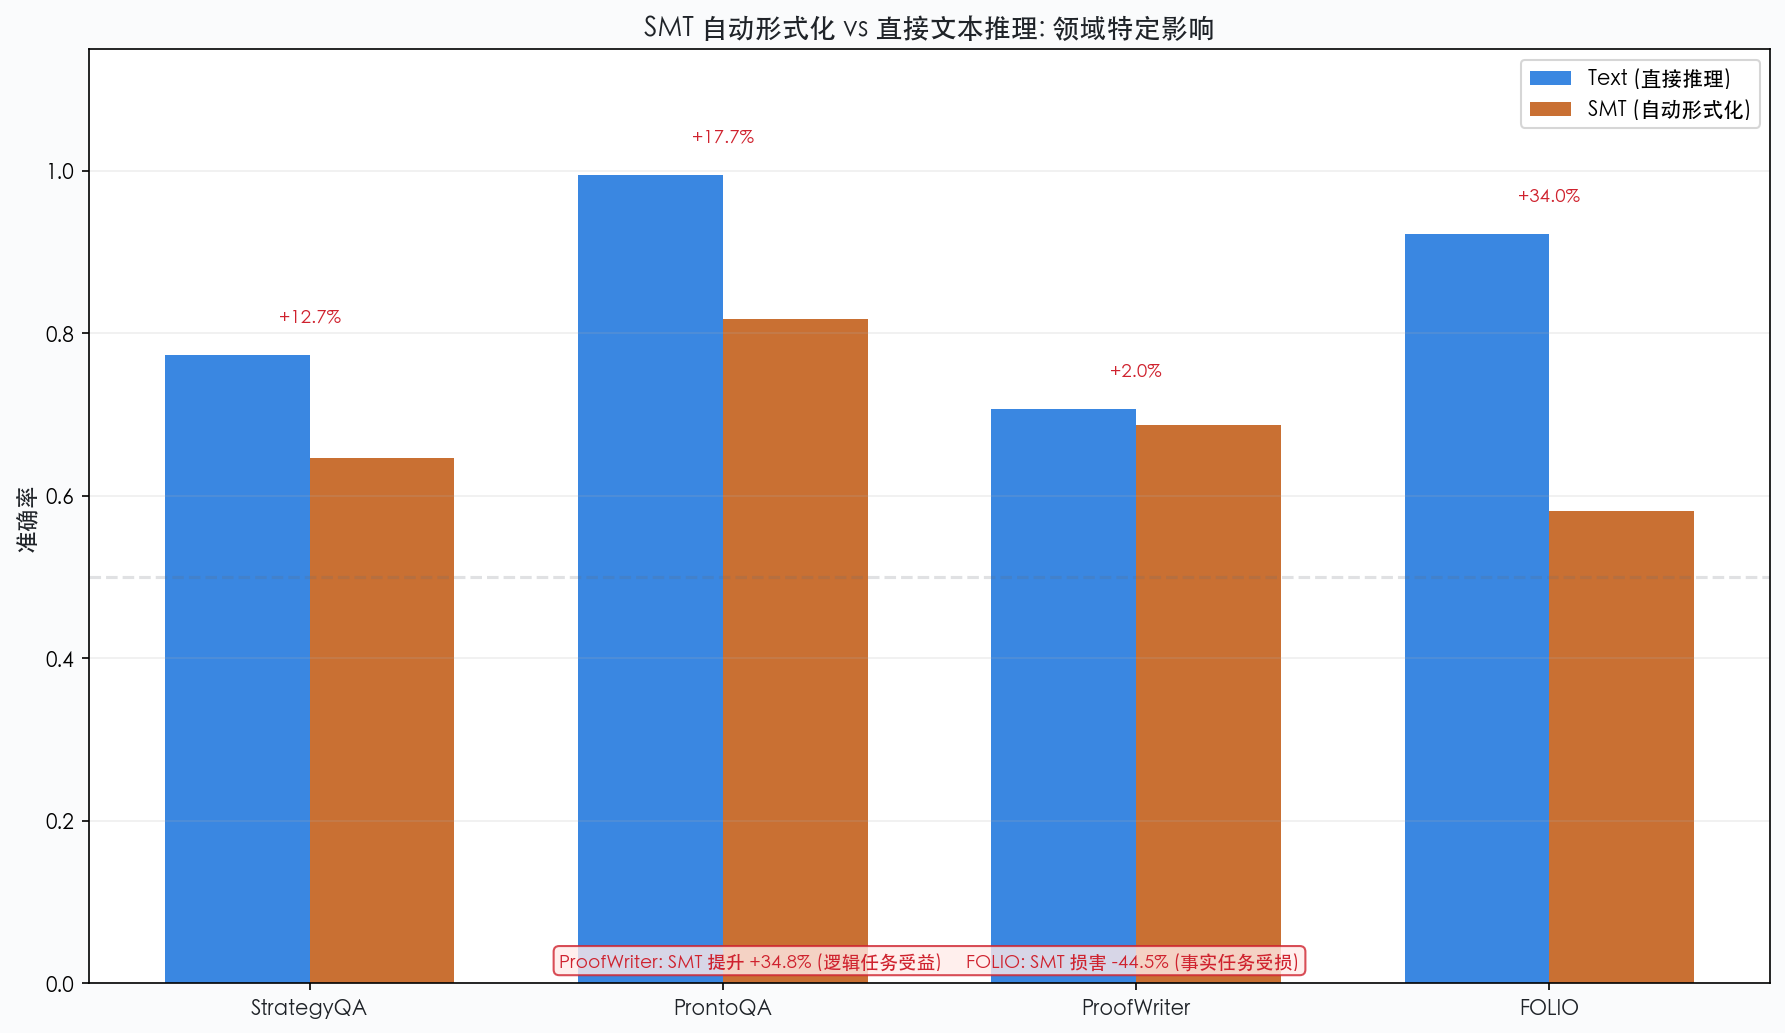
论文在四个形式推理数据集上评估了五个前沿 LLM(o3-mini、DeepSeek-R1、DeepSeek-v3、Gemini Flash 2.0、Gemini Flash 2.0 Lite),发现基于 SMT 的自动形式化对准确率的影响是领域特定的:
| 数据集 | 任务类型 | Text vs SMT 准确率变化 | 核心原因 |
|---|---|---|---|
| ProofWriter | 符号逻辑推理 | +34.8% | 精度和召回同时提高 |
| StrategyQA | 知识密集型推理 | 混合结果 | SMT 以精度换召回 |
| ProntoQA | 算术链式推理 | SMT 不一致 | 文本推理多数更优 |
| FOLIO | 事实型一阶逻辑 | -44.5% | SMT 召回率严重降低 |
[译注]:ProofWriter 的提升源于其任务与符号逻辑密切相关——前提显式给出,推理路径清晰。而 FOLIO 需要世界知识辅助,SMT 自动形式化在此反而引入噪声。
更关键的是,论文证明已知的不确定性量化技术(如 token 概率的熵)无法捕获足够信息来识别形式验证产物中的错误。这意味着传统 UQ 方法在形式推理场景中存在根本性的盲区。
2. PCFG 框架:用文法建模 LLM 输出分布
论文的理论核心是使用**概率上下文无关文法(PCFG)**来近似 LLM 生成 SMT-LIB 程序的内部概率分布。形式化设定如下:
- 设 为有限字母表,SMT-LIB 语言
- 对于任务 和参数为 的 LLM,LLM 在 上诱导概率测度
- 有效 SMT-LIB 程序上的条件测度:
PCFG 是五元组 ,推导 的概率为 。通过从 LLM 生成 个 SMT-LIB 程序样本,用 SMT-LIB v2 文法解析,然后用最大似然估计(MLE)计算规则概率:
论文还证明了覆盖保证定理(Theorem 1):对于任何质量为 的可测子集 , 个样本全部缺失 的概率至多为 ,其中 是 Shannon 熵。这为采样充分性提供了理论保证。
3. 25 个不确定性指标与四分类体系
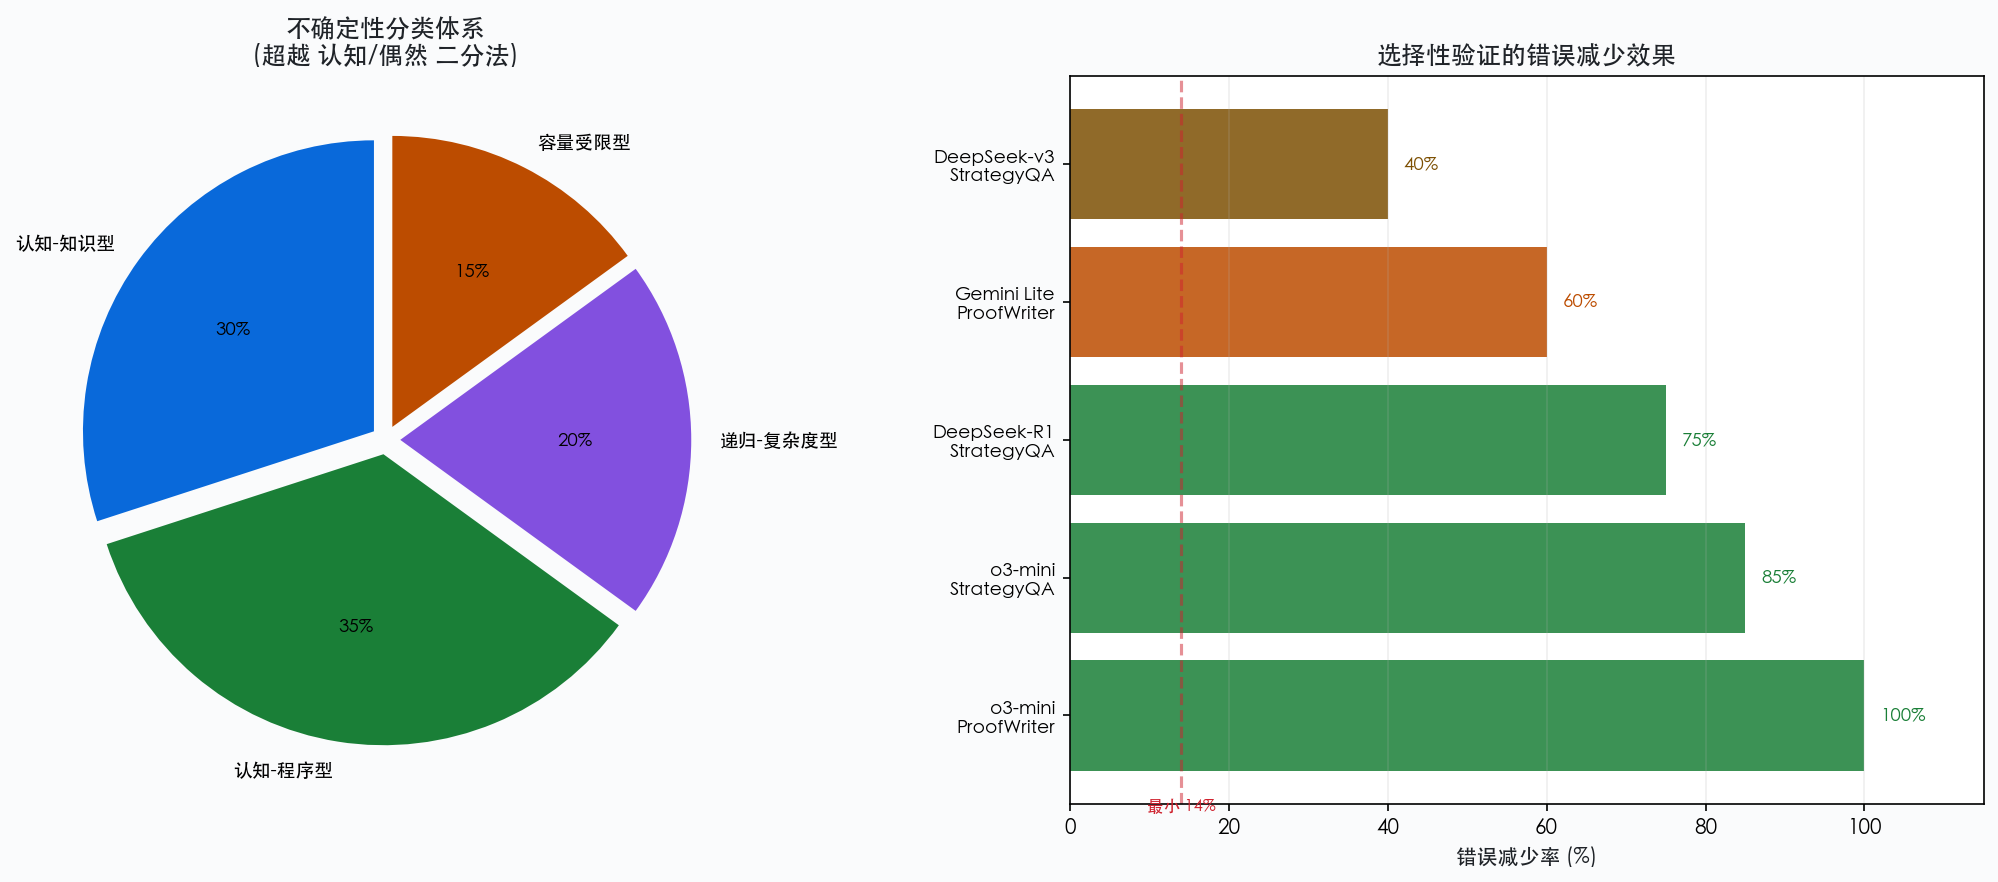
论文开发了 25 个 PCFG 派生指标,并提出了超越传统认知/偶然(Epistemic/Aleatoric)二分法的精细化四分类:
| 不确定性类型 | 核心特征 | 主导任务 | 最佳指标 | AUROC |
|---|---|---|---|---|
| 认知-知识型 | 世界知识不确定性 | StrategyQA | 跨模态一致性 | 0.74-0.78 |
| 认知-程序型 | 形式规则应用 | ProofWriter | 文法熵 | >0.93 |
| 递归-复杂度型 | 过度递归结构 | ProntoQA | 谱半径 | 0.64 |
| 容量受限型 | 模型容量限制 | ProofWriter (Lite) | 规则分布峰度 | 0.87 |
[译注]:四分类体系中最深刻的发现是"容量受限型"——模型在最小和冗长 SMT 模式之间切换,产生双峰重尾分布。这不是知识或程序问题,而是模型容量本身导致的风格振荡,是一种全新的不确定性类型。
4. 任务依赖性与融合方法
论文最重要的实践发现是形式推理不确定性是任务依赖的:
- 知识密集型任务(StrategyQA):跨模态一致性指标一致主导,表明世界知识中的认知不确定性是主要瓶颈
- 前提显式推理任务(ProofWriter):PCFG 派生指标展现出色判别力,文法熵 AUROC=0.9301,确认程序性认知不确定性占主导
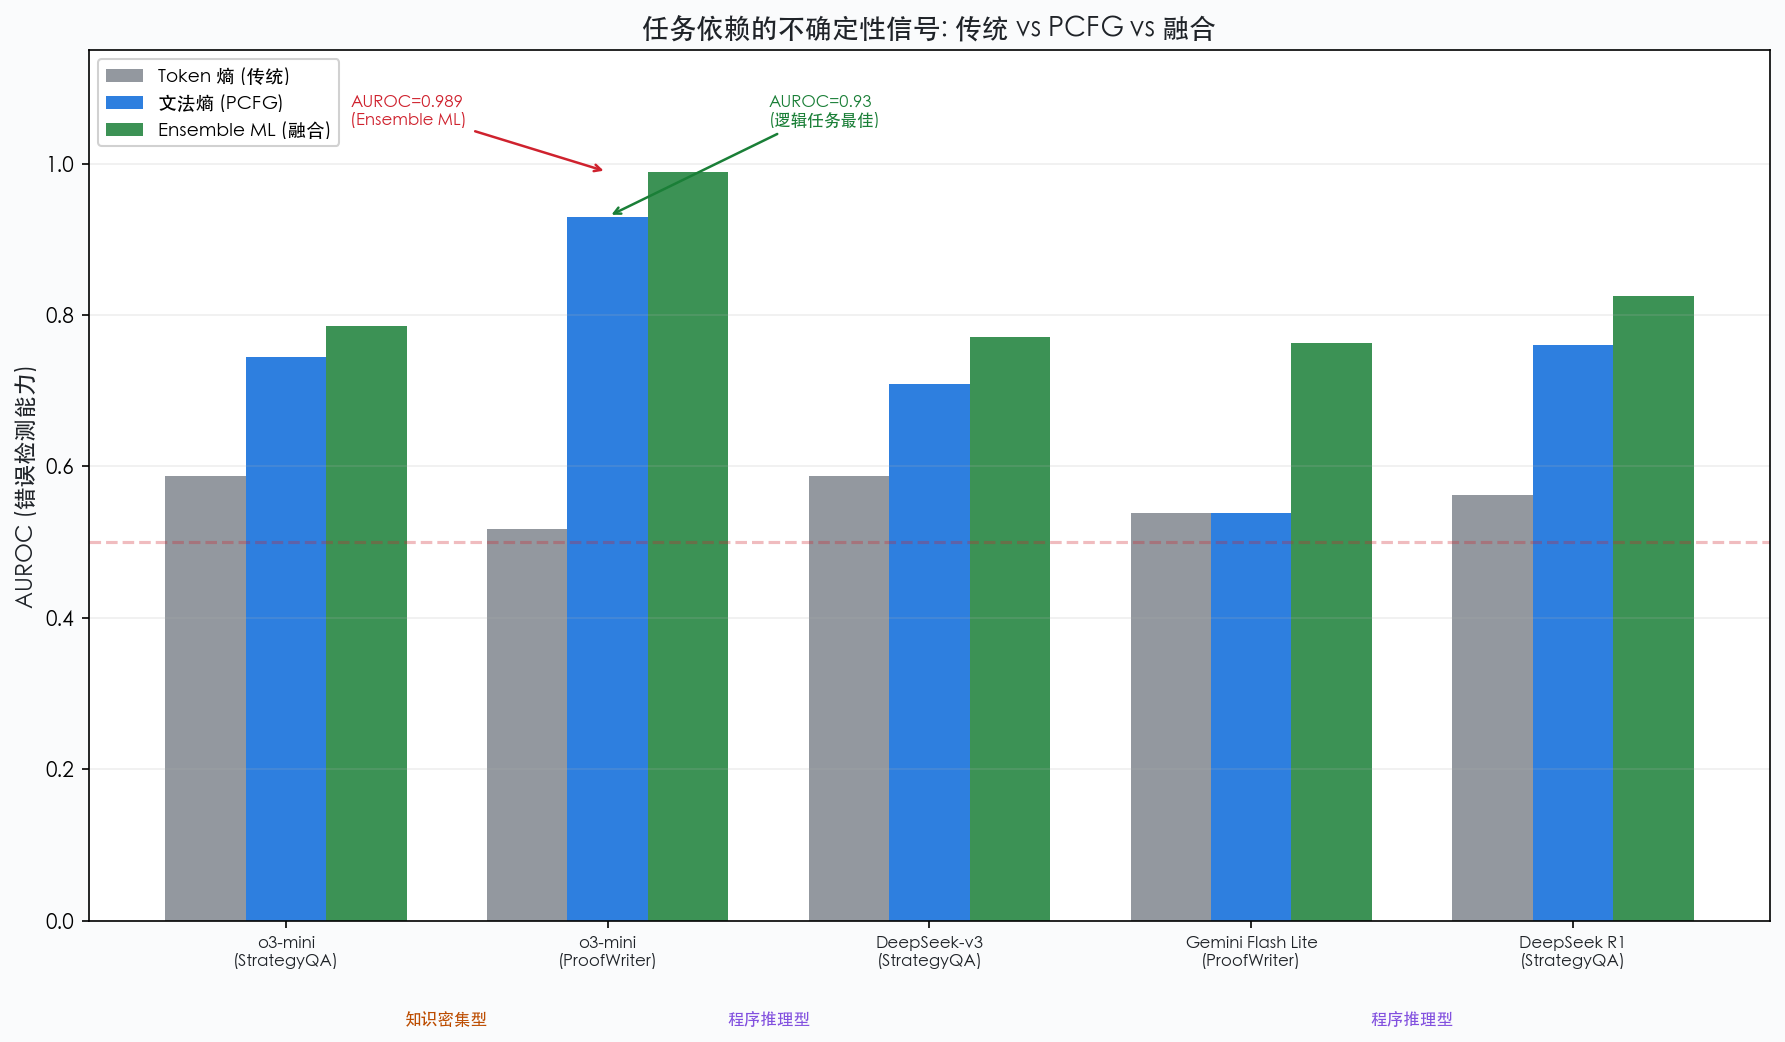
轻量级、模型无关的多信号融合方法(Ensemble ML)在所有设置中优于单一指标,实现了选择性验证——在最小弃权的情况下将错误率降低 14-100%。
方法论详解
PCFG 近似流程
1. 使用 SMT-LIB v2 文法 G_SMT 作为结构基础
2. 从目标 LLM 生成 N 个 SMT-LIB 程序样本 P_N = {P_1, ..., P_N}
3. 用 G_SMT 解析,得到解析树集合 Π(P_N)
4. 从每个解析树中识别并记录每条应用的产生式规则
5. 用 MLE 估计规则概率: p_hat(r) = C(r) / C(A)
6. 计算 25 个不确定性指标
7. 融合信号实现选择性验证
关键指标
信息论度量:
- 每非终结符 Shannon 熵:
- 整体文法熵:
- 困惑度:
NSUI(归一化结构不确定性指标):
其中 是文法均值矩阵的谱半径, 指示潜在无界推导。
谱性质:均值矩阵 的元素 表示非终结符 在 的产生式右侧出现的期望次数。谱半径反映递归复杂度。
实验结果
Token 级 UQ 的局限
传统指标(Entropy、Perplexity、Kurtosis)在四个数据集上 AUROC 普遍在 0.51-0.70 之间,不足以捕获形式化与推理过程中独特的认知不确定性。没有 UQ 方法在所有任务上一致出色。
PCFG 指标的卓越表现
| 模型-数据集组合 | 最佳 PCFG 指标 | AUROC | AURC | 错误减少 |
|---|---|---|---|---|
| o3-mini / ProofWriter | 文法熵 | 0.9301 | 0.0008 | ~100% |
| o3-mini / StrategyQA | Ensemble ML | 0.7850 | 0.1013 | ~85% |
| DeepSeek-R1 / StrategyQA | 文本一致性 | 0.7835 | 0.0983 | ~75% |
| Gemini Lite / ProofWriter | SMT 一致性 | 0.7364 | 0.1031 | ~60% |
不对称自一致性
论文发现了一个有趣现象:LLM 可能使用不同的、未完美对齐的形式与文本推理路径。例如在 Gemini/ProntoQA 上,SMT 一致性 AUROC=0.9291 而文本一致性仅 0.5108。这暗示神经符号设计应从"翻译焦点"转向"路径对齐和接地"。
启示与思考
对 AARM 框架的直接启示
这篇论文与 AARM 三层架构中的副作用验证层高度契合。论文的核心洞见——LLM 生成形式产物的句法非典型性作为语义错误的强大信号——可以转化为 AgentMonitor 的检测规则:
- 句法指纹检测:当 LLM 正确理解逻辑关系时,一致产生高概率规则序列;语义误解表现为统计异常,创造独特的"推理失败的句法指纹"
- 任务感知 UQ 策略:不同 Agent 任务类型需要不同的不确定性信号——知识密集型任务需要跨模态一致性,程序推理型任务需要 PCFG 结构指标
- 选择性验证架构:不是所有 Agent 输出都需要完整验证,通过 UQ 信号融合可以在最小弃权下大幅减少错误
局限性与未来方向
论文的一个隐含局限是:PCFG 近似的准确性依赖于采样数量 N 和 SMT-LIB 文法的完整性。覆盖保证定理给出了理论边界,但在实践中,对于高熵分布(如复杂形式化任务),可能需要不切实际的大量样本。
此外,论文聚焦于 SMT-LIB 作为中间表示,但 Agent 工作流中的形式产物可能涉及更丰富的类型系统(如 Lean4 的依赖类型)。将 PCFG 框架扩展到依赖类型语言是一个有价值的未来方向。
我觉得这篇论文最深刻的贡献不是任何单一指标,而是**将 LLM 输出的概率性从"缺陷"重新定位为"信息源"**这一认识论转向。在形式验证领域,概率性传统上被视为需要消除的噪声;而论文证明,通过恰当的文法建模,这种概率性可以成为指导验证的信号。这种思维转换对整个神经符号系统领域都有深远影响。
参考链接
- arXiv: https://arxiv.org/abs/2505.20047
- HTML 全文: https://arxiv.org/html/2505.20047v1
- 代码: 未公开
- 相关数据集: StrategyQA, ProntoQA, ProofWriter, FOLIO