LLM 主动消歧:从贝叶斯实验设计看 Agent 如何提问
Active Task Disambiguation with LLMs
剑桥大学团队提出将 LLM 任务消歧问题框架化为贝叶斯实验设计,通过采样解空间直接估计问题的信息增益(EIG),绕过 LLM 元认知能力的短板。在 20 问答和代码生成两个实验中验证了方法的有效性。
论文概览
论文: Active Task Disambiguation with LLMs 作者: Katarzyna Kobalczyk, Nicolás Astorga, Tennison Liu, Mihaela van der Schaar 机构: DAMTP, University of Cambridge 发表: ICLR 2025 arXiv: 2502.04485
这篇论文关注一个实际但容易被忽视的问题:当用户给 LLM 的指令存在歧义时,Agent 该如何主动提问来消除歧义?作者将这个问题形式化为贝叶斯实验设计(Bayesian Experimental Design, BED)框架下的信息增益最大化问题,提出了一套"采样解空间 → 估计问题效用 → 选择最优问题"的 Active Task Disambiguation 方法。
核心思路很直接:与其指望 LLM 直接"想出"一个好的澄清问题(隐式推理),不如让 LLM 先采样多个候选解,然后基于这些解来显式估计每个候选问题能带来多少信息增益。这是一种将推理负荷从问题空间转移到解空间的策略。
问题定义:任务歧义
论文首先给出了任务歧义的形式化定义。设问题陈述 ,其中 是需求集合(任何合格解都应满足), 是上下文信息。设 为满足需求的解空间, 为真正可接受的解集合。
定义 1(任务歧义): 当 时,即满足需求的解空间严格大于可接受的解空间,问题陈述 是歧义的。
这个定义的关键在于区分了客观的需求满足()和主观的偏好分布()。需求满足是客观的——代码是否通过测试用例、函数是否实现了指定功能;而偏好是主观的——不同的用户可能对同一需求有不同的期望。
论文对比了两种解决路径:
- 偏好优化(如 RLHF/DPO):让 对齐总体人群的平均偏好。但当个体用户偏离平均值时,这种方法可能失败。
- 迭代任务引出:通过交互对话获取额外规格,逐步缩小解空间。本文聚焦于后者。
核心方法:EIG 估计
贝叶斯实验设计视角
在 BED 框架下,每个问题 就是一个"实验",回答 是实验结果,生成的解 是感兴趣的未知量。信息增益定义为:
由于提问时回答 未知,需要取期望信息增益(EIG):
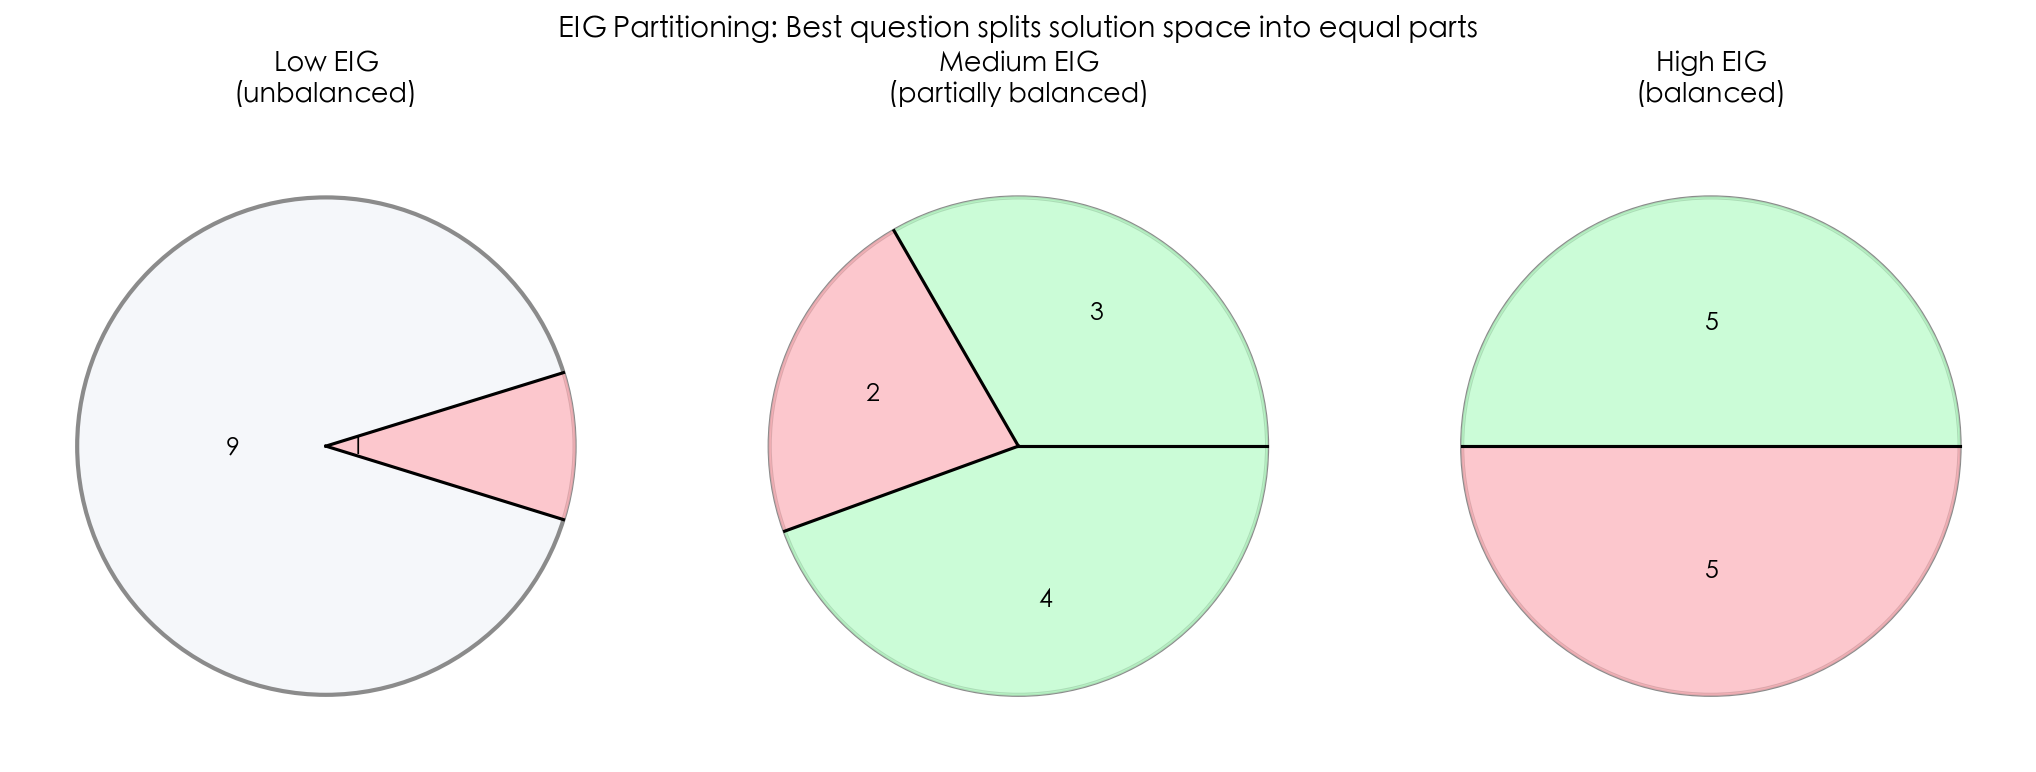
均匀性假设与等分原理
由于真实分布 未知,且 LLM 的生成分布 可能有偏,作者采用了一个关键假设:将 近似为解空间上的均匀分布。在此假设下推导得到:
这个量在 等大时最小,即最优问题是将解空间等分为 份的问题。对于二元问题(yes/no),最优问题是将解空间一分为二的问题。
算法流程
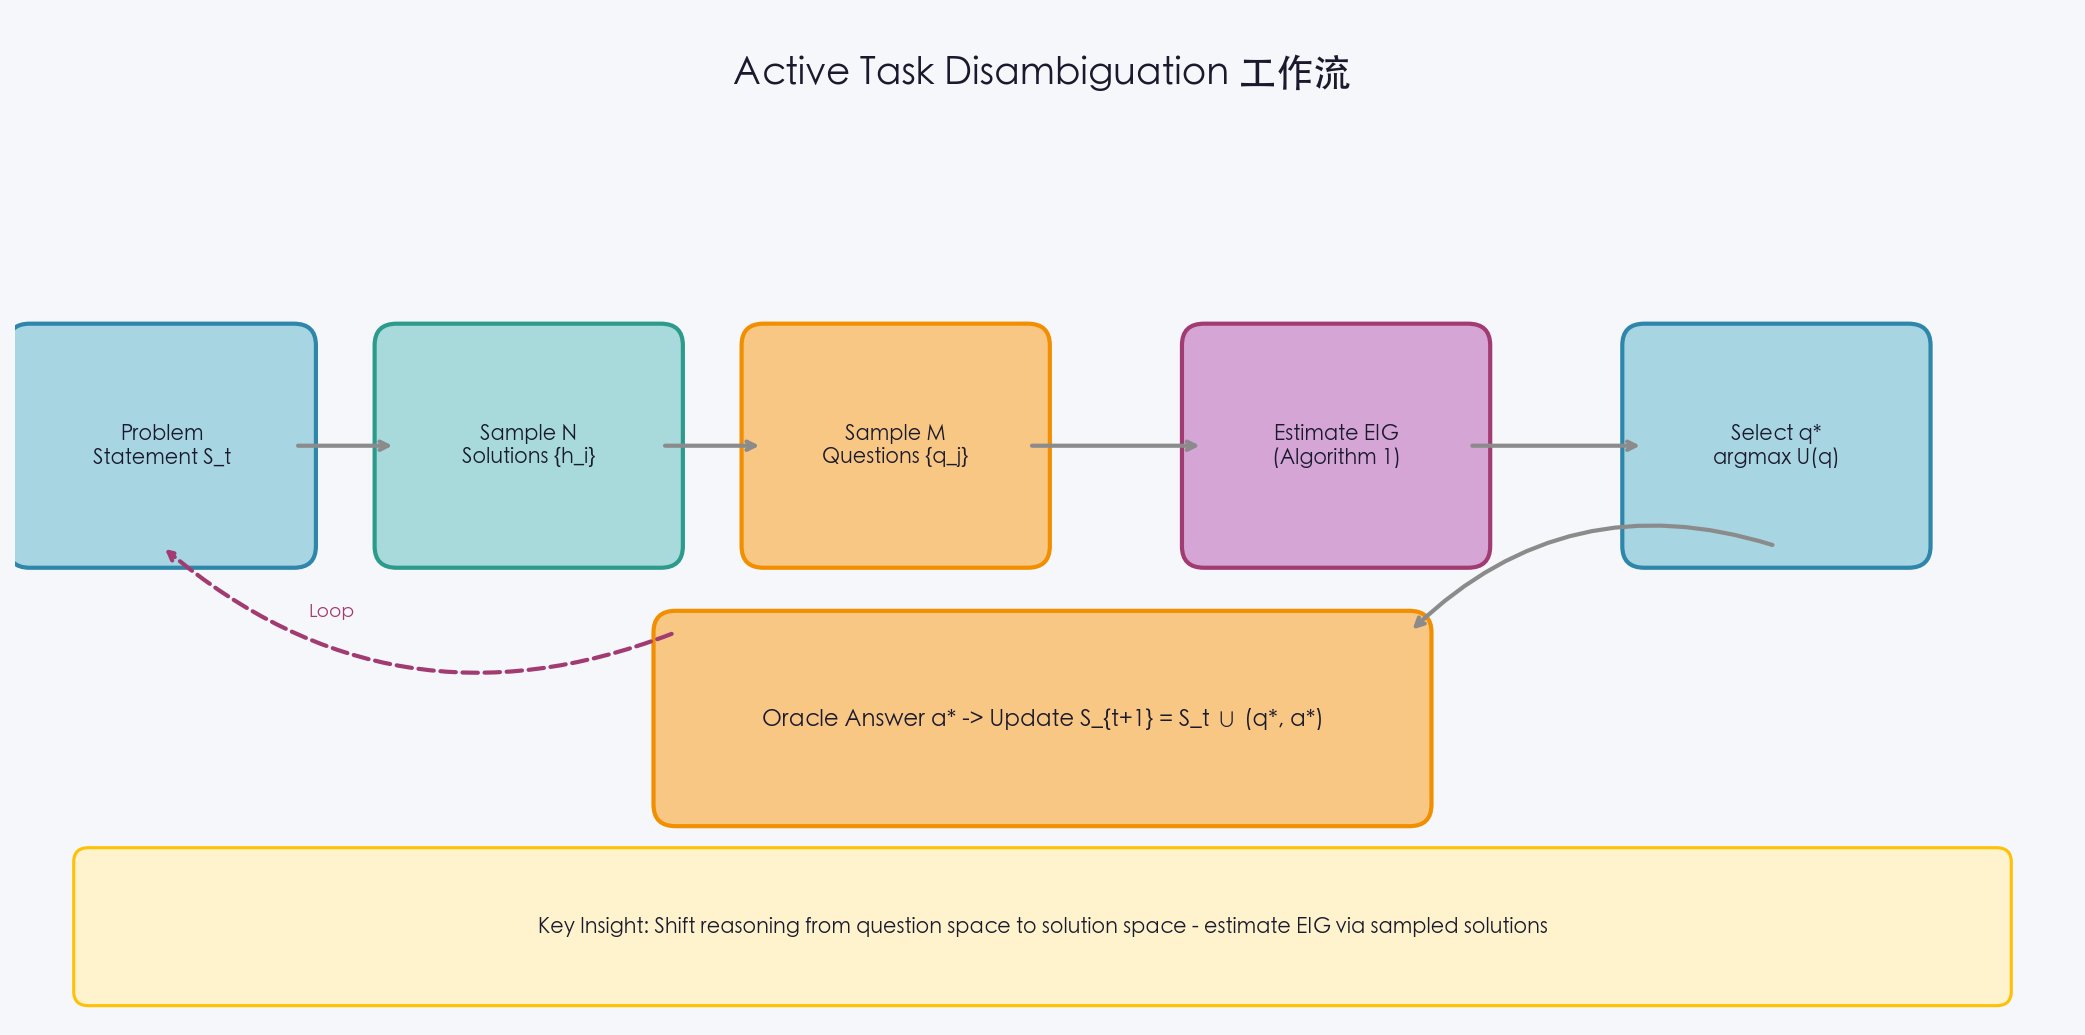
在每一轮交互 :
- 从 采样 个候选解
- 从 采样 个候选问题
- 对每个问题 关于每个解 生成伪回答
- 用 Algorithm 1 估计每个问题的 EIG
- 选择
- 获取真实回答 ,更新
EIG 的估计(Algorithm 1)本质上是计算回答分布的负熵:
Algorithm 1: estimate EIG(q_j, {a_{i,j}})
  {a_1, ..., a_n} ← Unique answers in {a_{i,j}}
  for k in {1, ..., n}:
    n_k ← |{i : a_{i,j} = a_k}|
    p_k ← n_k / n
  return -Σ p_k log(p_k)
当所有解给出相同的回答时,EIG = 0(问题无区分力);当回答均匀分布在多个类别上时,EIG 最大(问题区分力最强)。
实验结果
实验 1:20 问答游戏
在动物类别的 20 问答游戏中,玩家 B(LLM)需要在 10 轮内猜出玩家 A(GPT-4o-mini)心中的动物。比较了四种策略:
| 策略 | 描述 |
|---|---|
| implicit | 直接提示生成一个问题 |
| implicit-ToT | 采样 5 个问题,让 LLM 自选最佳 |
| EIG-uniform | 采样 5 个问题,用均匀假设估计 EIG 选最优 |
| EIG-logprobs | 同上,但用 LLM 的 logprobs 估计 |
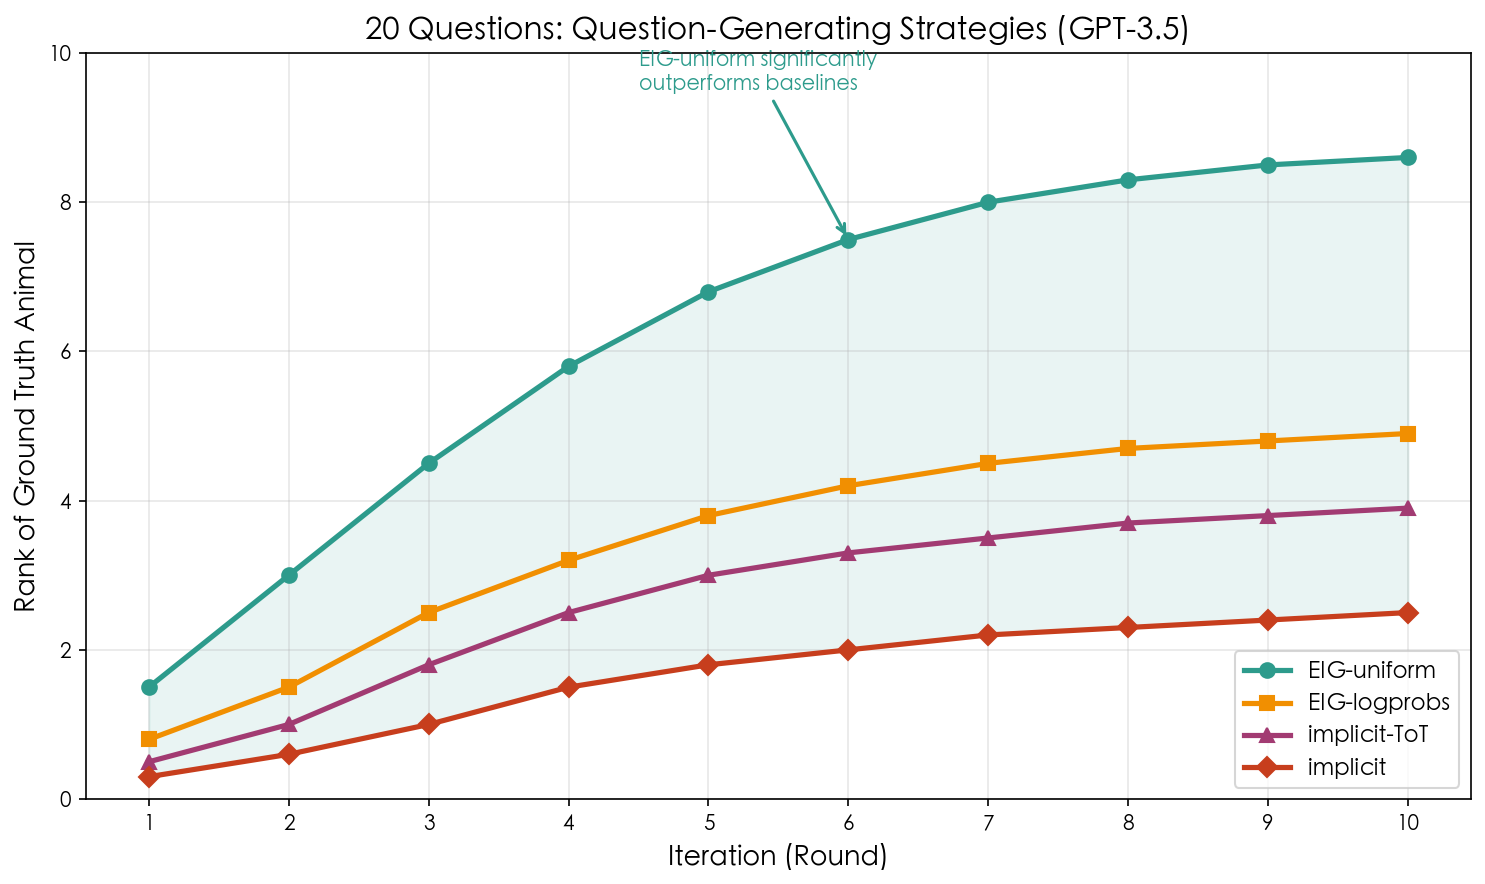
EIG-uniform 显著优于其他所有策略。几个关键发现:
- EIG-uniform 远超 implicit 和 implicit-ToT,验证了 H1:LLM 隐式推理"最好问什么"的能力不足
- EIG-logprobs 表现差于 EIG-uniform,说明 LLM 的生成分布有偏,logprobs 不能很好反映真实解空间的均匀性
- 对于更强的模型(GPT-4o-mini vs GPT-3.5),EIG 与基线的差距缩小——更强的模型在隐式推理上也有改善
论文还做了三个消融实验:
- 问题效用:用 500 个动物的大列表验证,EIG-uniform 生成的问题确实导致更小的兼容解集
- 解的多样性:加入"diverse and representative"提示显著提升样本多样性(互信息分数从 0.46→0.57)
- 需求兼容性:通过 self-critic 过滤不满足需求的采样解至关重要,2 次过滤步骤效果最佳
实验 2:主动代码生成
在代码生成场景中,问题被定义为测试用例:
- Binary (B): 生成一个断言语句,Oracle 确认 True/False
- Open (O): 生成一个函数输入,Oracle 返回期望输出
在 HumanEval 和 APPS 基准上,仅提问 4 轮后:
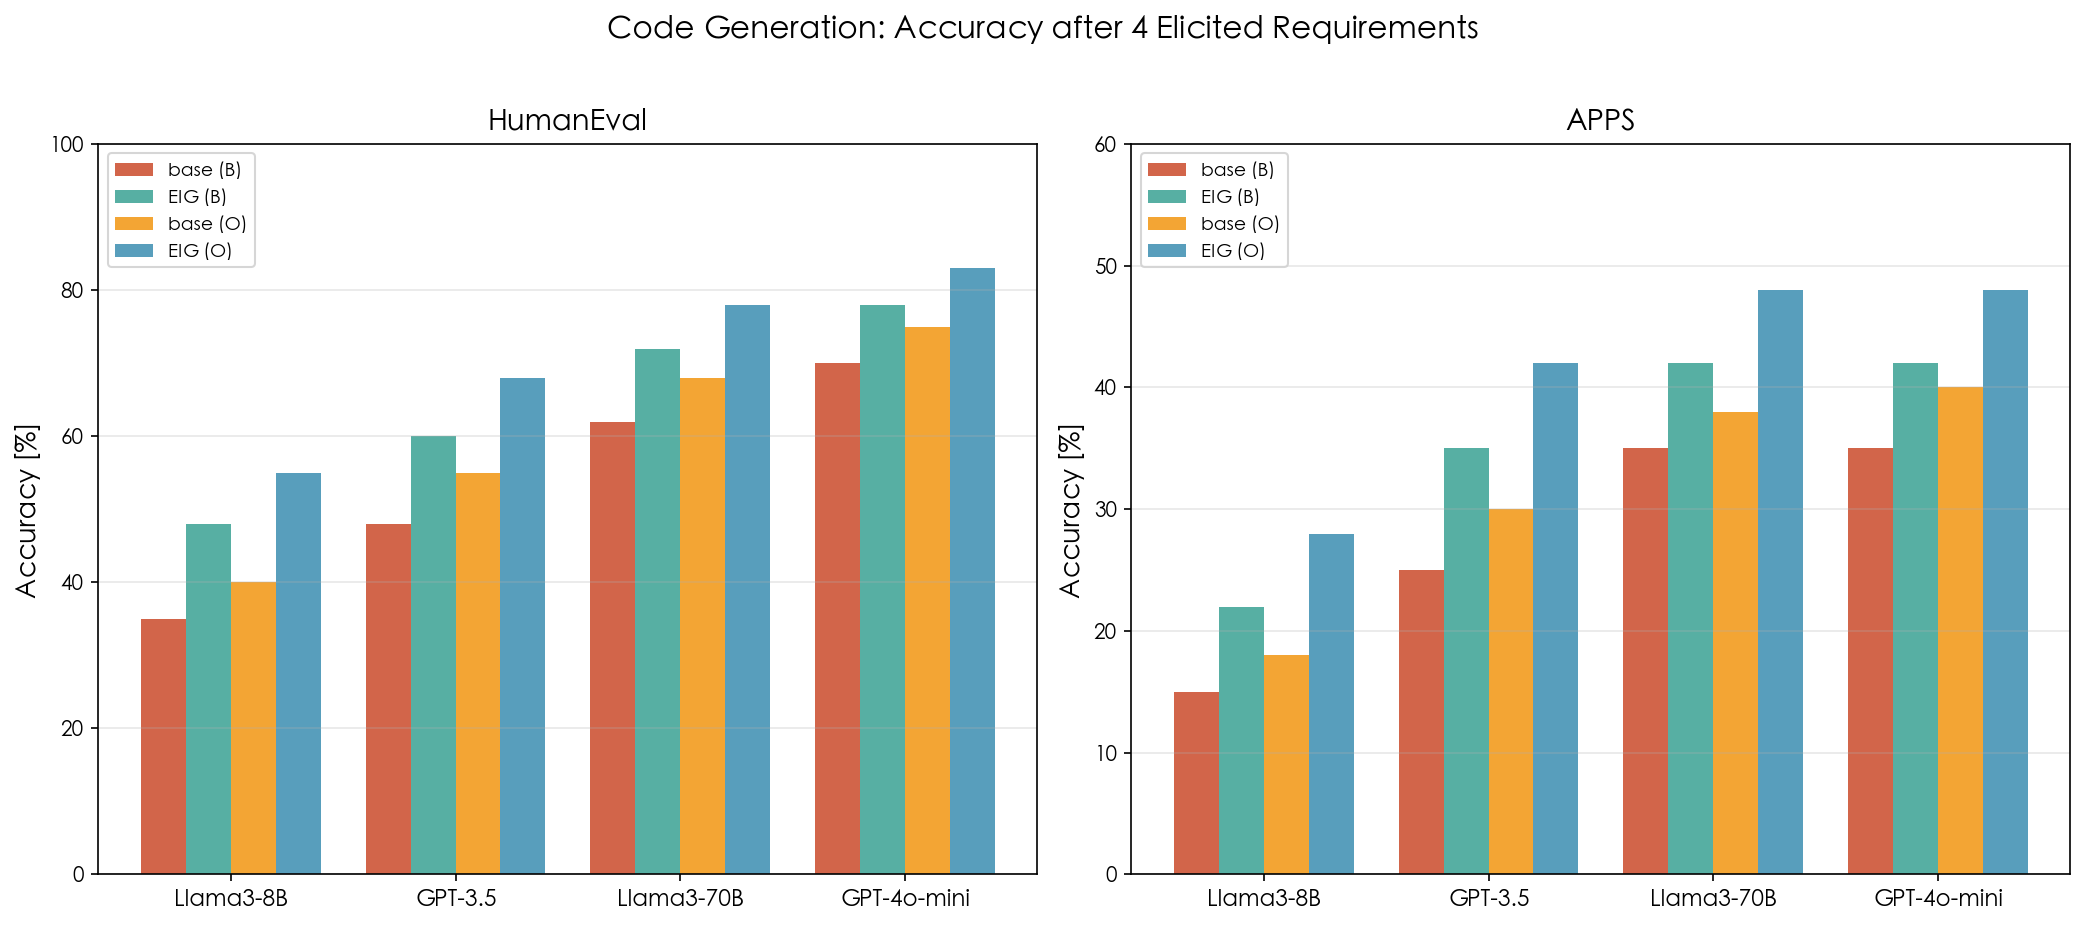
| 模型 | HumanEval base(B) | HumanEval EIG(O) | APPS base(B) | APPS EIG(O) |
|---|---|---|---|---|
| Llama3-8B | 35% | 55% | 15% | 28% |
| GPT-3.5 | 48% | 68% | 25% | 42% |
| Llama3-70B | 62% | 78% | 35% | 48% |
| GPT-4o-mini | 70% | 83% | 35% | 48% |
EIG 策略在所有模型和两个基准上都优于基线。Open 类型问题比 Binary 类型信息增益更大(符合理论预期:更多可能的回答意味着更大的 EIG 上界)。代码生成实验的关键优势是外部工具(Python 解释器)可以提供近乎无噪声的 EIG 估计。
启示与思考
元认知能力的缺口
这篇论文最深刻的洞察是:LLM 在"生成解"和"生成关于解的好问题"之间存在能力缺口。后者需要一种元认知能力——审视自己的生成分布,识别能区分不同解的特征。论文通过将这种隐式推理转化为显式的解空间采样+ EIG 估计,巧妙地绕过了这个缺口。
这启示我们,在构建 Agent 系统时,与其依赖 LLM 的"自省"能力,不如通过外部化的采样和计算来替代。类似思路在 self-consistency、Tree of Thoughts 等方法中也有体现——用采样+聚合替代单次推理。
实际应用考量
在真实场景中应用这种方法需要注意几点:
- LLM 调用成本:每轮交互需要 次额外的 LLM 调用来生成伪回答。论文认为这相对于获取 Oracle 回答的成本可以忽略,但在实际部署中可能是一个瓶颈。
- 噪声控制:在无外部验证工具的场景(如 20 问答),需要通过 self-critic 等方式控制 LLM 幻觉。代码生成场景因为有解释器,EIG 估计更可靠。
- 停止条件:论文承认何时停止提问是一个未解决的问题。在实际应用中,可能需要结合 ambiguity 检测或设定信息增益阈值。
更广的视角
从更广的视角看,这篇工作连接了两个领域:传统的实验设计理论(BED)和现代 LLM Agent 的交互设计。它提醒我们,LLM Agent 不应该只是被动地接受指令然后输出——主动提问、主动获取信息是一个更负责任、更鲁棒的交互范式。随着 Agent 在医疗诊断、法律咨询等高风险场景的部署,这种主动消歧能力将变得越来越重要。